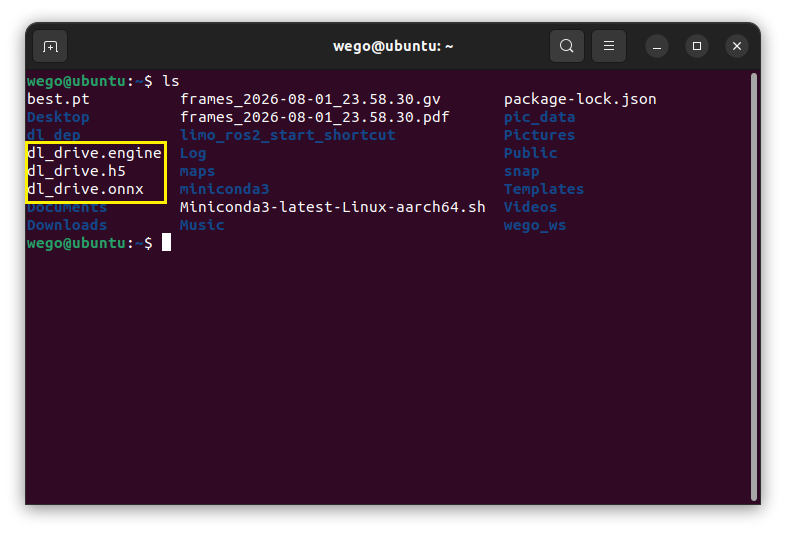
1. 학습 모델을 Wego LIMO로 복사하기
Google Colab에서 학습한 파일을 다운로드한 뒤 Wego LIMO로 복사합니다.
TensorFlow 모델 파일 예시는 다음과 같습니다.
dl_drive.h5
YOLO 모델 파일 예시는 다음과 같습니다.
best.pt
SCP를 사용할 경우 다음과 같이 전송할 수 있습니다.
scp dl_drive.h5 wego@<LIMO_IP_ADDRESS>:/home/wego/
scp best.pt wego@<LIMO_IP_ADDRESS>:/home/wego/
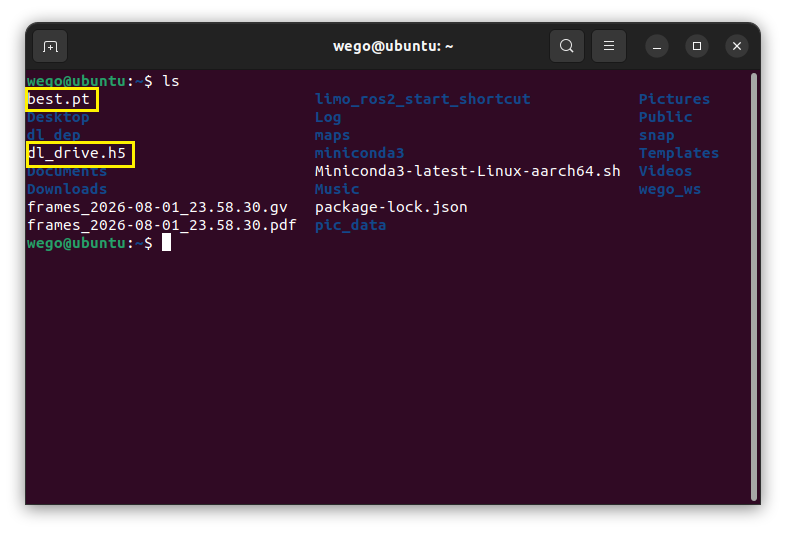
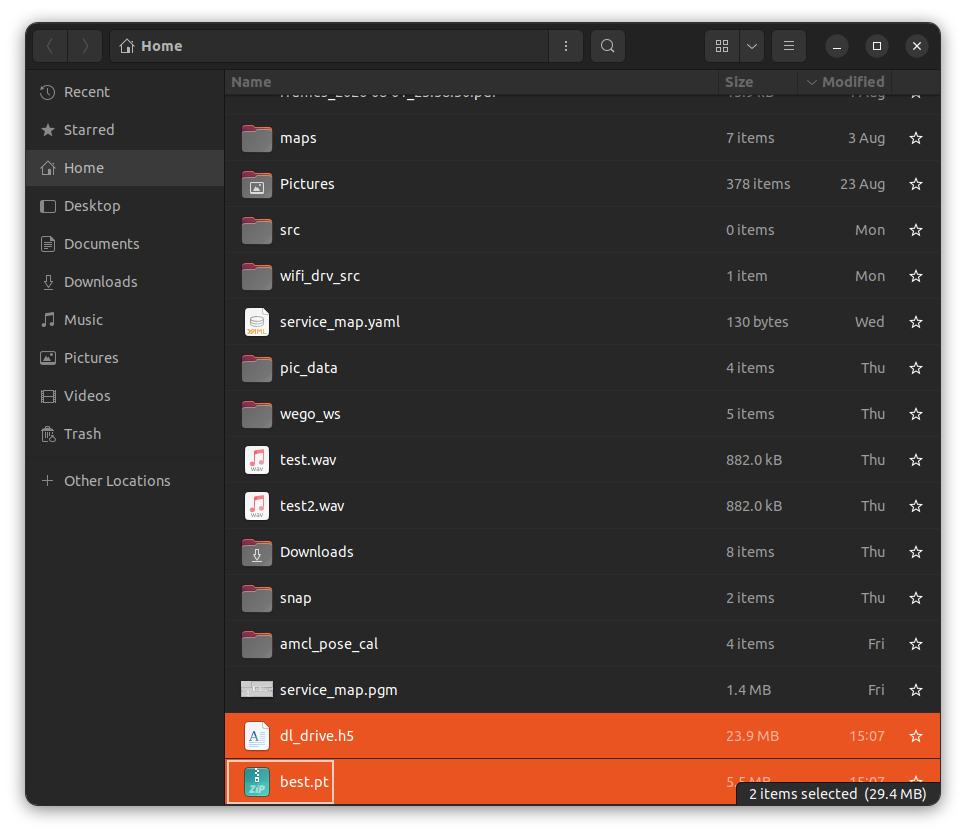
<LIMO_IP_ADDRESS>는 실제 Wego LIMO의 IP 주소로 변경합니다.
2. 딥러닝 모델 최적화가 필요한 이유
TensorFlow의 .h5 모델이나 YOLO의 .pt 모델을 그대로 실행할 수도 있지만, 임베디드 환경에서는 추론 시간이 길어질 수 있습니다.
Wego LIMO에서 실시간에 가까운 속도로 동작시키려면 NVIDIA TensorRT 엔진으로 변환하는 것이 좋습니다.
TensorRT 최적화를 적용하면 다음과 같은 효과를 기대할 수 있습니다.
- GPU 추론 속도 향상
- 모델 실행 지연 감소
- 메모리 사용 최적화
- 반복 추론 성능 향상
- ROS 2 카메라 처리 주기 안정화
다만 TensorRT 엔진 파일은 일반적으로 생성한 장치의 GPU 구조, TensorRT 버전, CUDA 버전에 영향을 받습니다. 다른 Jetson 또는 다른 소프트웨어 환경에서 생성한 엔진을 그대로 복사하면 실행되지 않을 수 있습니다.
가장 안전한 방법은 실제로 모델을 실행할 Wego LIMO 장치에서 엔진 파일을 생성하는 것입니다.
3. TensorFlow 주행 모델 최적화
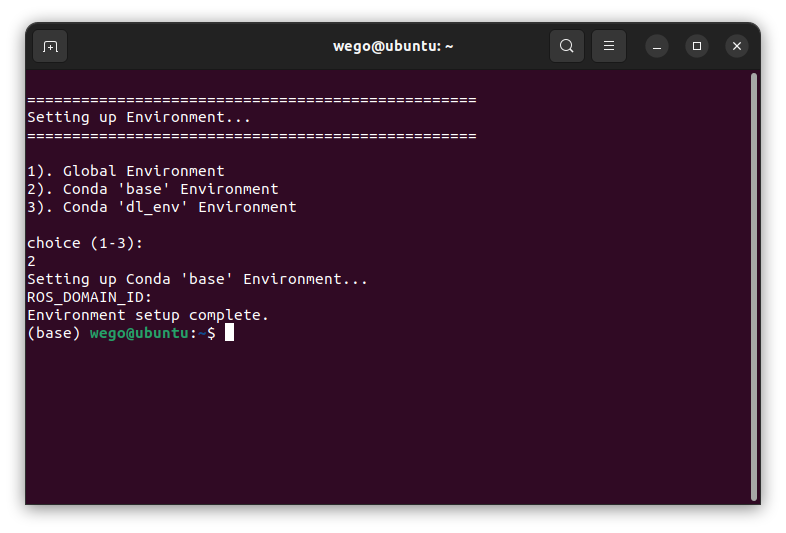
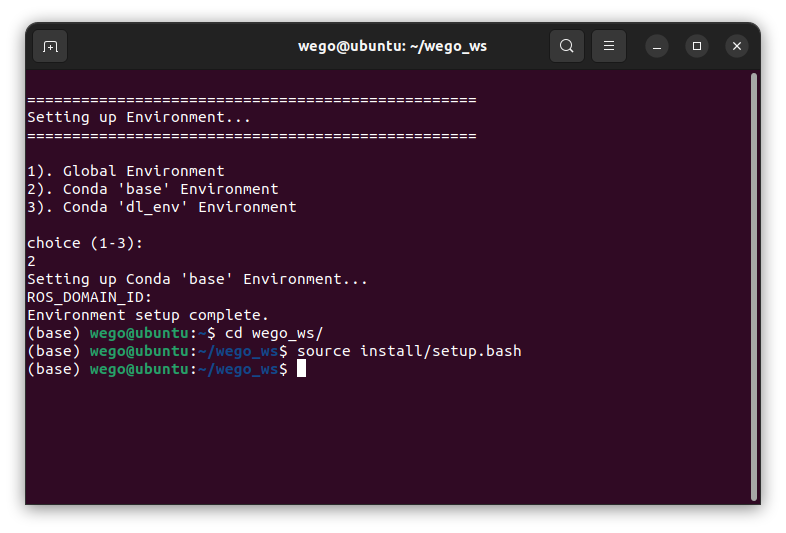
먼저 Wego LIMO에서 딥러닝용 Conda 환경을 활성화합니다.
conda activate dl_env
또는 터머널 실행 시 2번을 선택합니다.
ROS 2 작업 공간으로 이동합니다.
cd ~/wego_ws
빌드된 ROS 2 환경을 적용합니다.
source install/setup.bash
TensorFlow .h5 모델을 TensorRT 엔진으로 변환합니다.
ros2 run dl_ros2_application tf_to_trt <h5_file_path>
예를 들어 모델이 /home/wego/dl_drive.h5에 있다면 다음과 같이 실행합니다.
ros2 run dl_ros2_application tf_to_trt /home/wego/dl_drive.h5
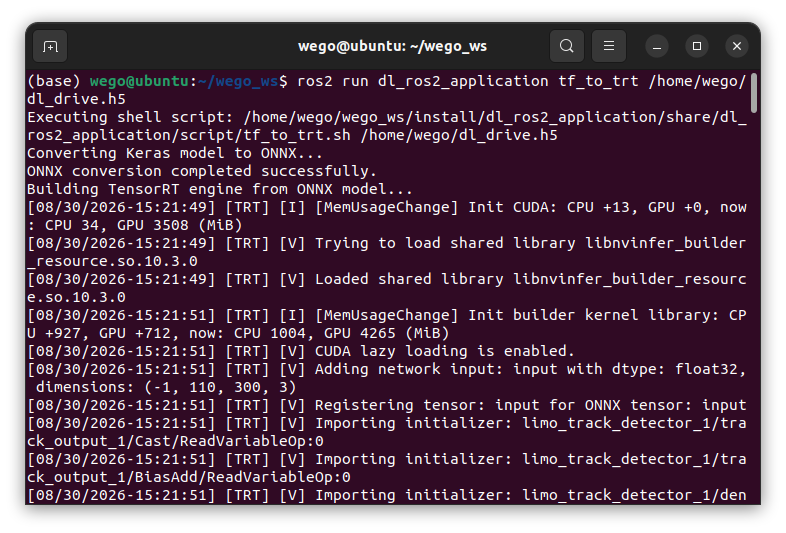
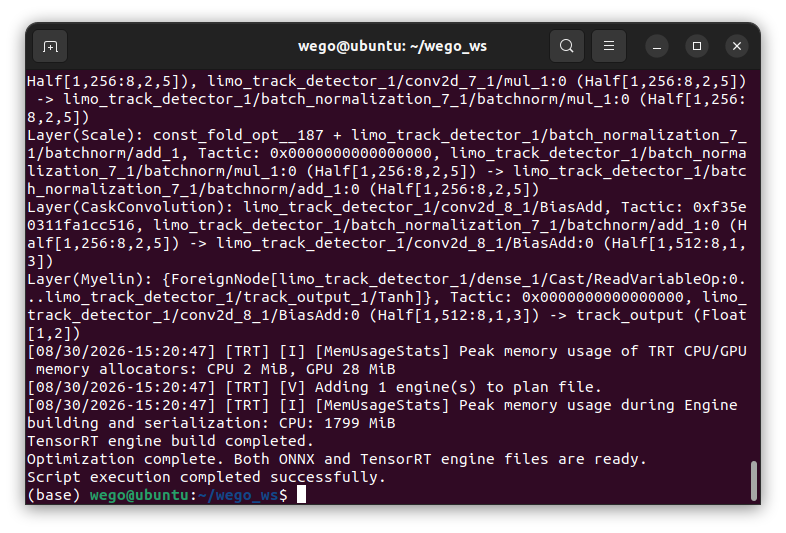
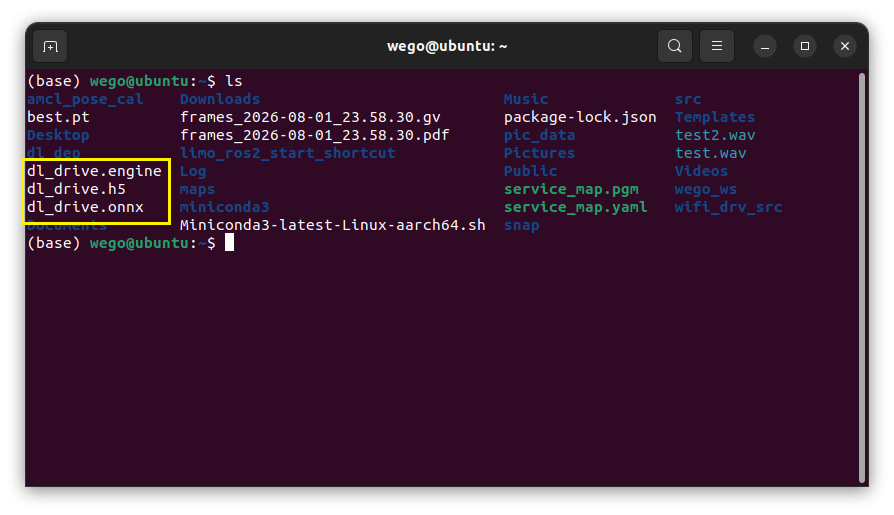
변환 프로그램은 일반적으로 다음 과정을 수행합니다.
- H5 모델 로드
- 중간 모델 형식으로 변환
- TensorRT 네트워크 생성
- 최적화 프로파일 구성
- 엔진 빌드
.engine파일 저장
모델 구조와 장치 성능에 따라 엔진 생성 과정에서 GPU 메모리를 많이 사용할 수 있습니다. 다른 딥러닝 노드가 실행 중이라면 종료한 뒤 변환하는 것이 좋습니다.
4. YOLO 객체 인식 모델 최적화
YOLO 모델도 동일하게 딥러닝 환경을 활성화합니다.
conda activate dl_env
cd ~/wego_ws
source install/setup.bash
YOLO .pt 모델을 TensorRT 엔진으로 변환합니다.
ros2 run dl_ros2_application yolo_to_trt <pt_file_path>
예를 들어 학습된 모델이 /home/wego/best.pt에 있다면 다음 명령을 사용합니다.
ros2 run dl_ros2_application yolo_to_trt /home/wego/best.pt
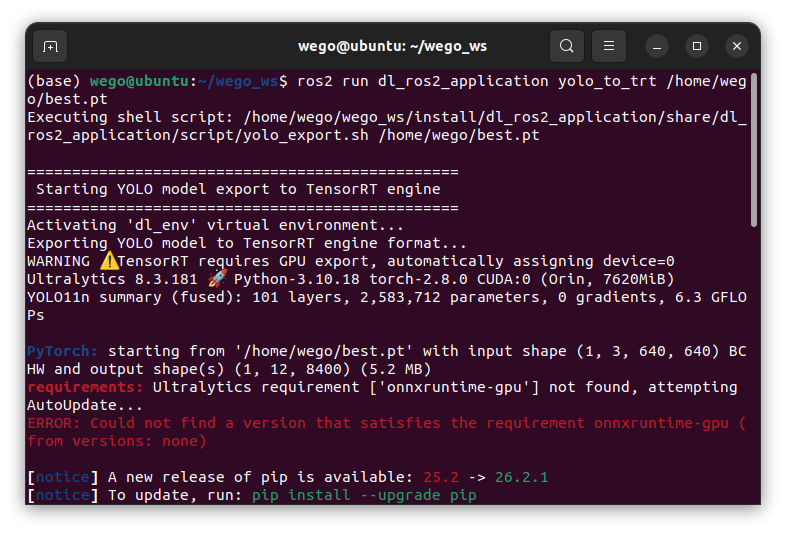
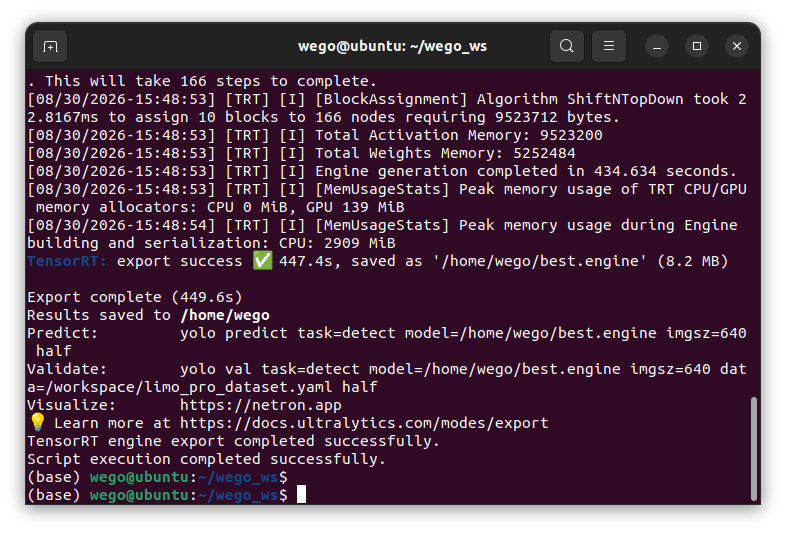
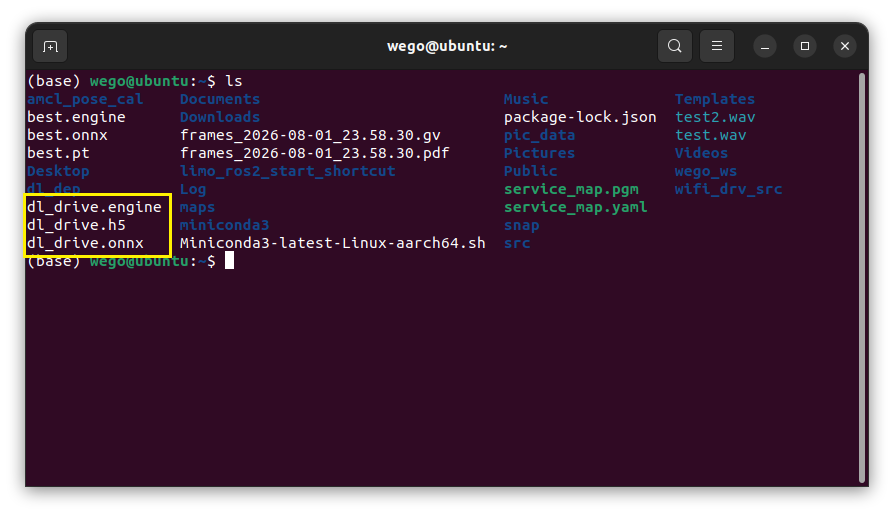
변환이 정상적으로 완료되면 .engine 확장자의 TensorRT 모델이 생성됩니다.
생성된 파일 이름과 저장 위치는 패키지 구현에 따라 달라질 수 있으므로 변환 로그를 확인해야 합니다.
find /home/wego -name "*.engine" 2>/dev/null

생성한 가중치 파일들을 아래의 위치로 복사합니다.
/home/wego/wego_ws/src/dl_ros2_application/weight/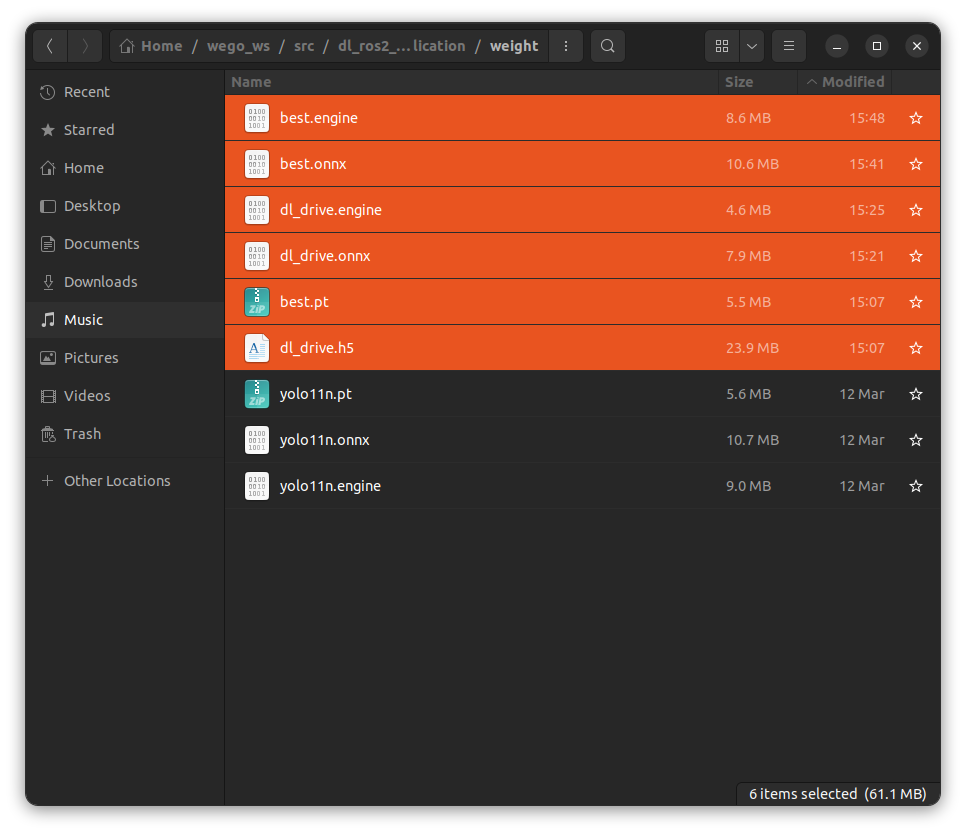
재 빌드를 실행합니다.
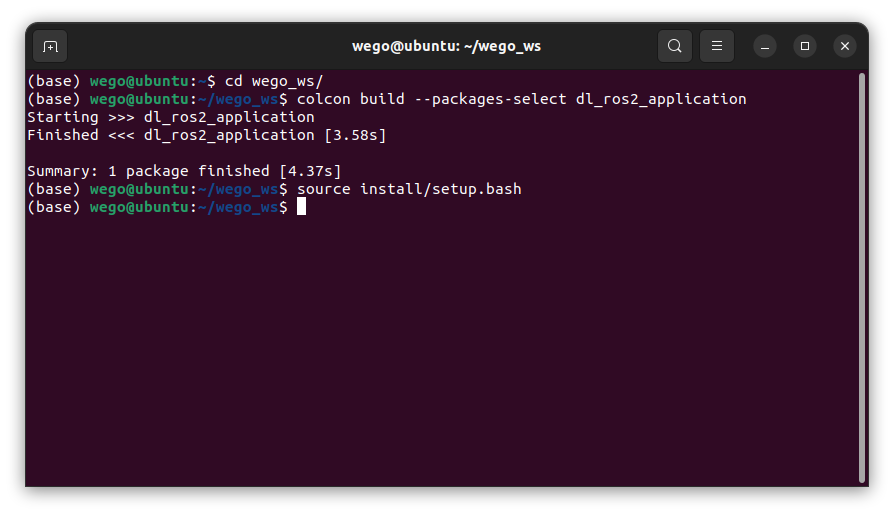
5. TensorRT 엔진 생성 전 확인 사항
엔진 변환 전에 다음 항목을 확인합니다.
nvidia-smi
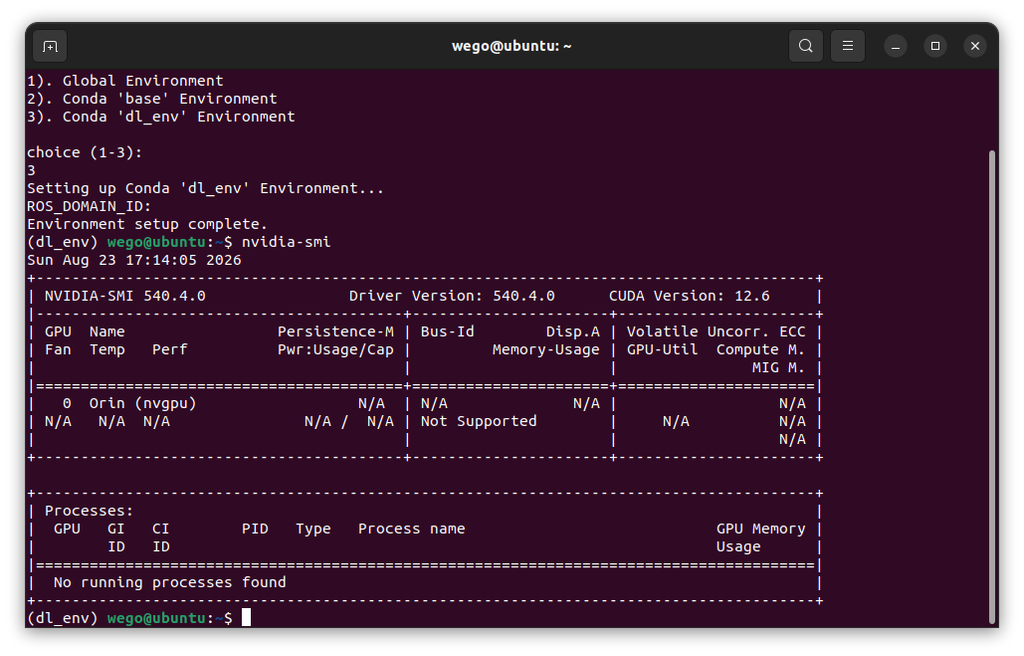
Jetson 환경에서는 nvidia-smi가 지원되지 않을 수 있으므로 다음 명령도 사용할 수 있습니다.
tegrastats
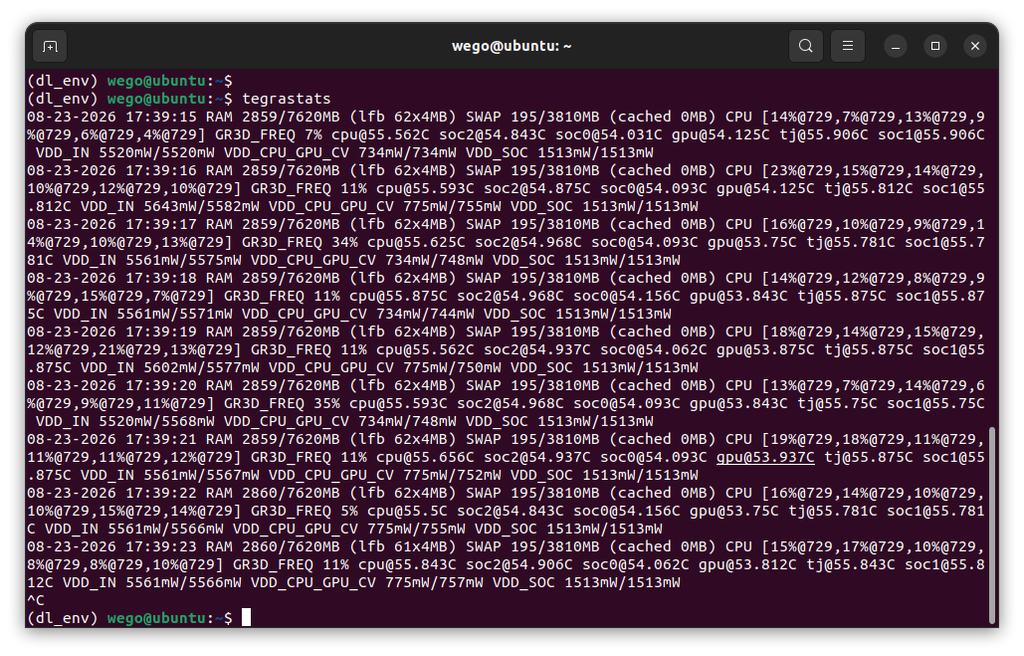
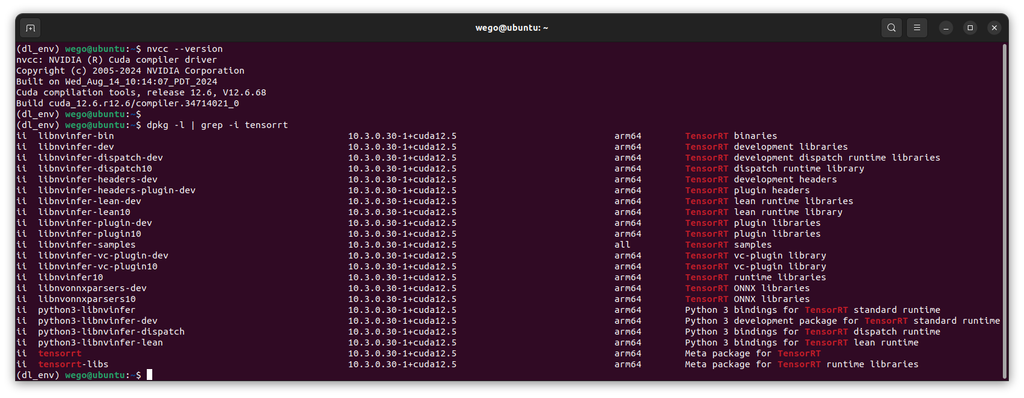
CUDA와 TensorRT 설치 상태를 확인합니다.
nvcc --version
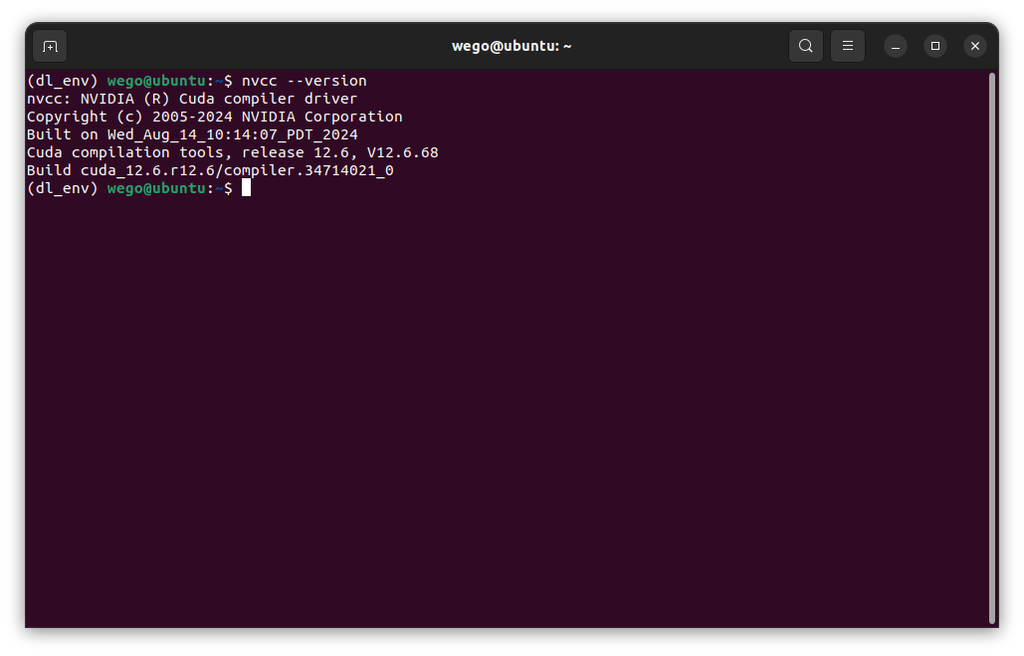
dpkg -l | grep -i tensorrt
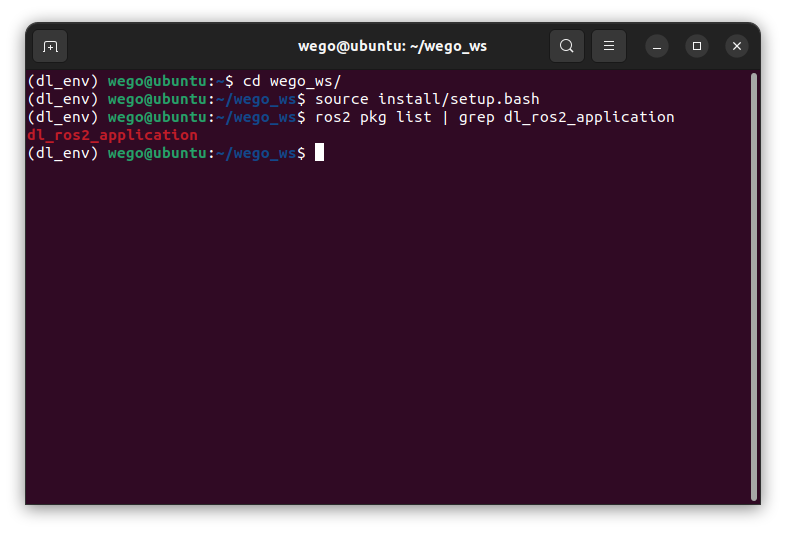
ROS 2 패키지가 정상적으로 인식되는지도 확인합니다.
ros2 pkg list | grep dl_ros2_application
실행 파일 목록은 다음 명령으로 확인할 수 있습니다.
ros2 pkg executables dl_ros2_application

tf_to_trt 또는 yolo_to_trt가 표시되지 않는다면 작업 공간 빌드 상태를 점검해야 합니다.
cd ~/wego_ws
colcon build --symlink-install
source install/setup.bash