신경회로망의 탄생부터 TensorFlow CNN, YOLO11 객체검출까지
ROS 2를 이용하면 로봇의 센서, 모터, 카메라, LiDAR, Navigation2 같은 기능을 하나의 시스템으로 연결할 수 있습니다. 하지만 ROS 2 자체가 카메라 영상 속 사물이 무엇인지 판단하거나 도로의 진행 방향을 스스로 학습하는 것은 아닙니다.
이 역할을 담당하는 대표적인 기술이 머신러닝(Machine Learning)과 딥러닝(Deep Learning)입니다.
이번 과정에서는 LIMO 로봇의 카메라 영상을 이용하여 크게 두 가지 딥러닝 기능을 다룹니다.
- 카메라 영상으로부터 주행에 필요한 연속값을 예측하는 TensorFlow CNN 회귀 모델
- 카메라 영상에서 특정 표지나 객체의 종류와 위치를 찾아내는 YOLO11n 객체검출 모델
1. 인공지능, 머신러닝, 딥러닝은 무엇이 다른가
가장 먼저 용어를 정리해야 합니다.
Artificial Intelligence
인공지능
     │
     └── Machine Learning
         머신러닝
              │
              └── Deep Learning
                  딥러닝
인공지능은 가장 넓은 개념입니다. 컴퓨터가 사람의 지능적인 행동을 모방하도록 만드는 전체 기술을 의미합니다.
머신러닝은 사람이 모든 규칙을 직접 프로그램하지 않고 데이터를 이용하여 규칙을 학습시키는 방법입니다.
딥러닝은 머신러닝 중에서도 여러 층으로 구성된 인공신경망을 사용하는 방법입니다.
전통적인 프로그램을 생각해 보겠습니다.
영상 + 사람이 만든 규칙
           ↓
        프로그램
           ↓
          결과
예를 들어 빨간색 표지판을 찾는 프로그램이라면 사람이 직접 다음 규칙을 작성할 수 있습니다.
R 값이 크고
G 값이 작고
B 값이 작으면
빨간색으로 판단
하지만 딥러닝에서는 접근 방법이 다릅니다.
영상 + 정답
   ↓
Neural Network Training
   ↓
Model
   ↓
새로운 영상
   ↓
Prediction
사람은 정답 데이터를 제공하고, 어떤 특징을 사용해야 하는지는 신경망이 학습합니다.
이 차이가 매우 중요합니다.
2. 신경회로망의 출발점 1943년 McCulloch-Pitts Neuron
오늘날 딥러닝의 역사는 보통 1943년 Warren McCulloch와 Walter Pitts의 연구에서 시작합니다.
두 연구자는 생물학적 뉴런의 동작을 매우 단순화하여 수학적·논리적 모델로 표현했습니다. 논문 제목은 A Logical Calculus of the Ideas Immanent in Nervous Activity입니다. 이 연구에서는 뉴런의 동작을 논리적인 ON/OFF 시스템처럼 다룰 수 있다는 개념이 제시되었습니다.
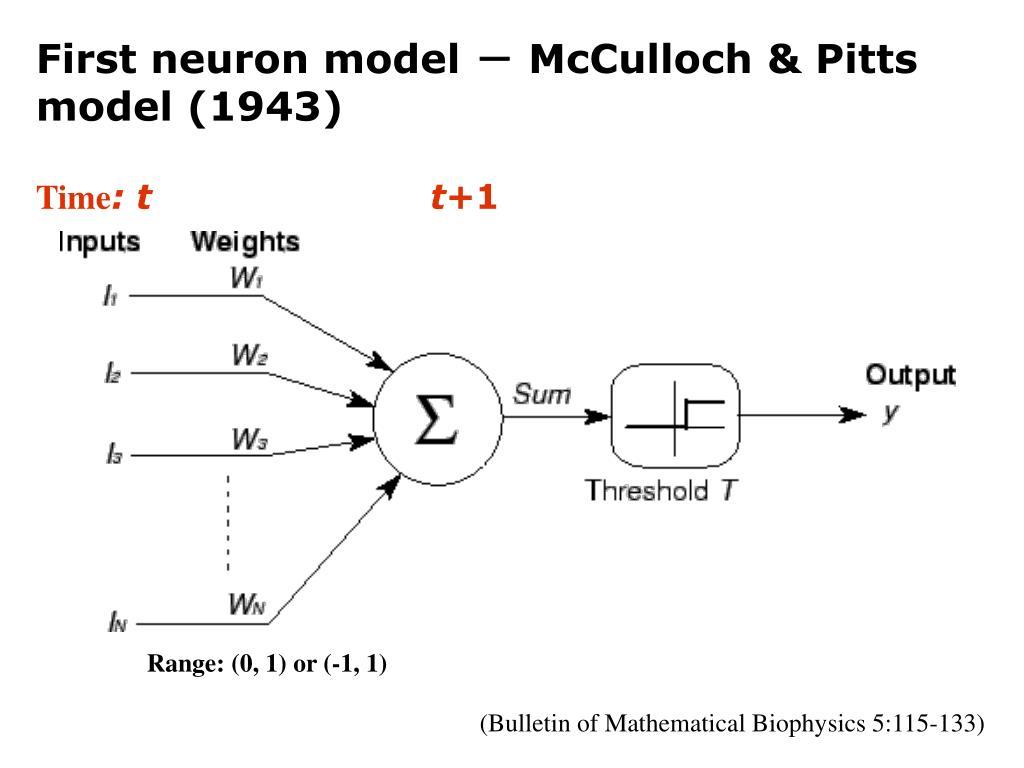
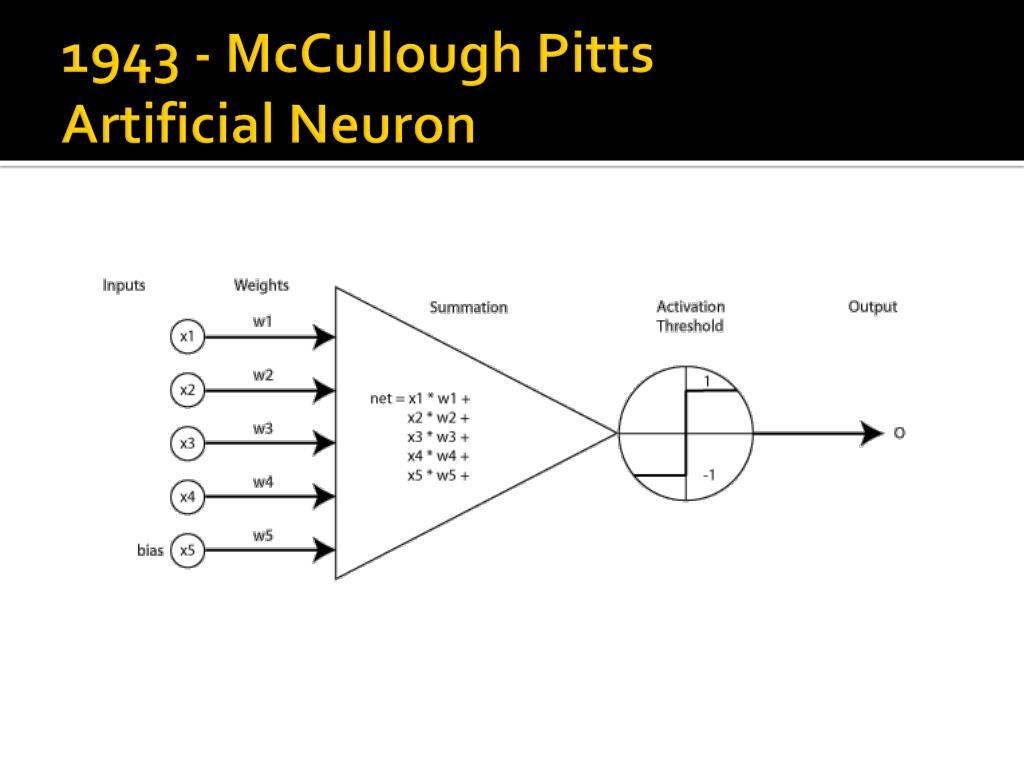
그림 2. McCulloch-Pitts 인공 뉴런을 설명하는 대표적인 구조도
기본 아이디어는 의외로 간단합니다.
여러 입력이 뉴런으로 들어갑니다.
x1 ──w1──┐
x2 ──w2──┤
x3 ──w3──┼──> 합산 ──> 임계값 ──> 출력
x4 ──w4──┘
입력마다 중요도가 다르기 때문에 각각 Weight, 가중치가 존재합니다.
현대 인공신경망의 기본 식으로 바꾸면 다음과 같습니다.
그리고 활성화 함수를 통과합니다.
이 구조는 80년 이상이 지난 현재의 딥러닝에서도 기본 원리는 그대로 사용됩니다.
3. 1957~1958년 Rosenblatt와 Perceptron
다음으로 중요한 인물은 Frank Rosenblatt입니다.
Rosenblatt는 1957년 Perceptron에 관한 보고서를 발표했고, 1958년에는 Psychological Review에 The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain을 발표했습니다.
Perceptron의 중요한 차이는 학습할 수 있다는 점입니다.
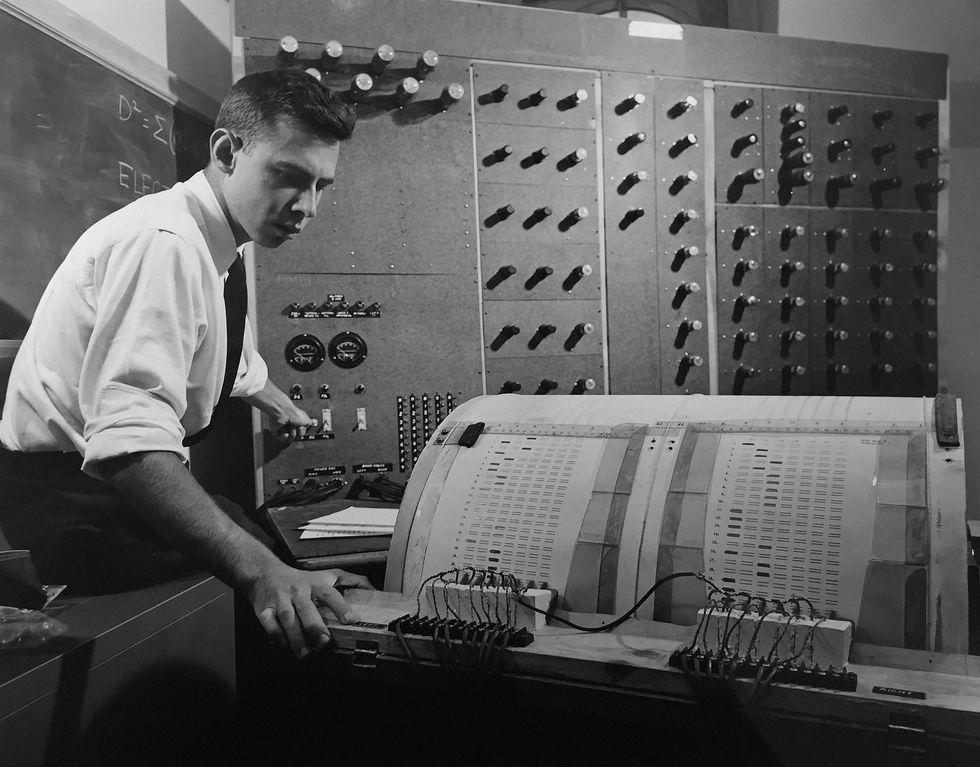
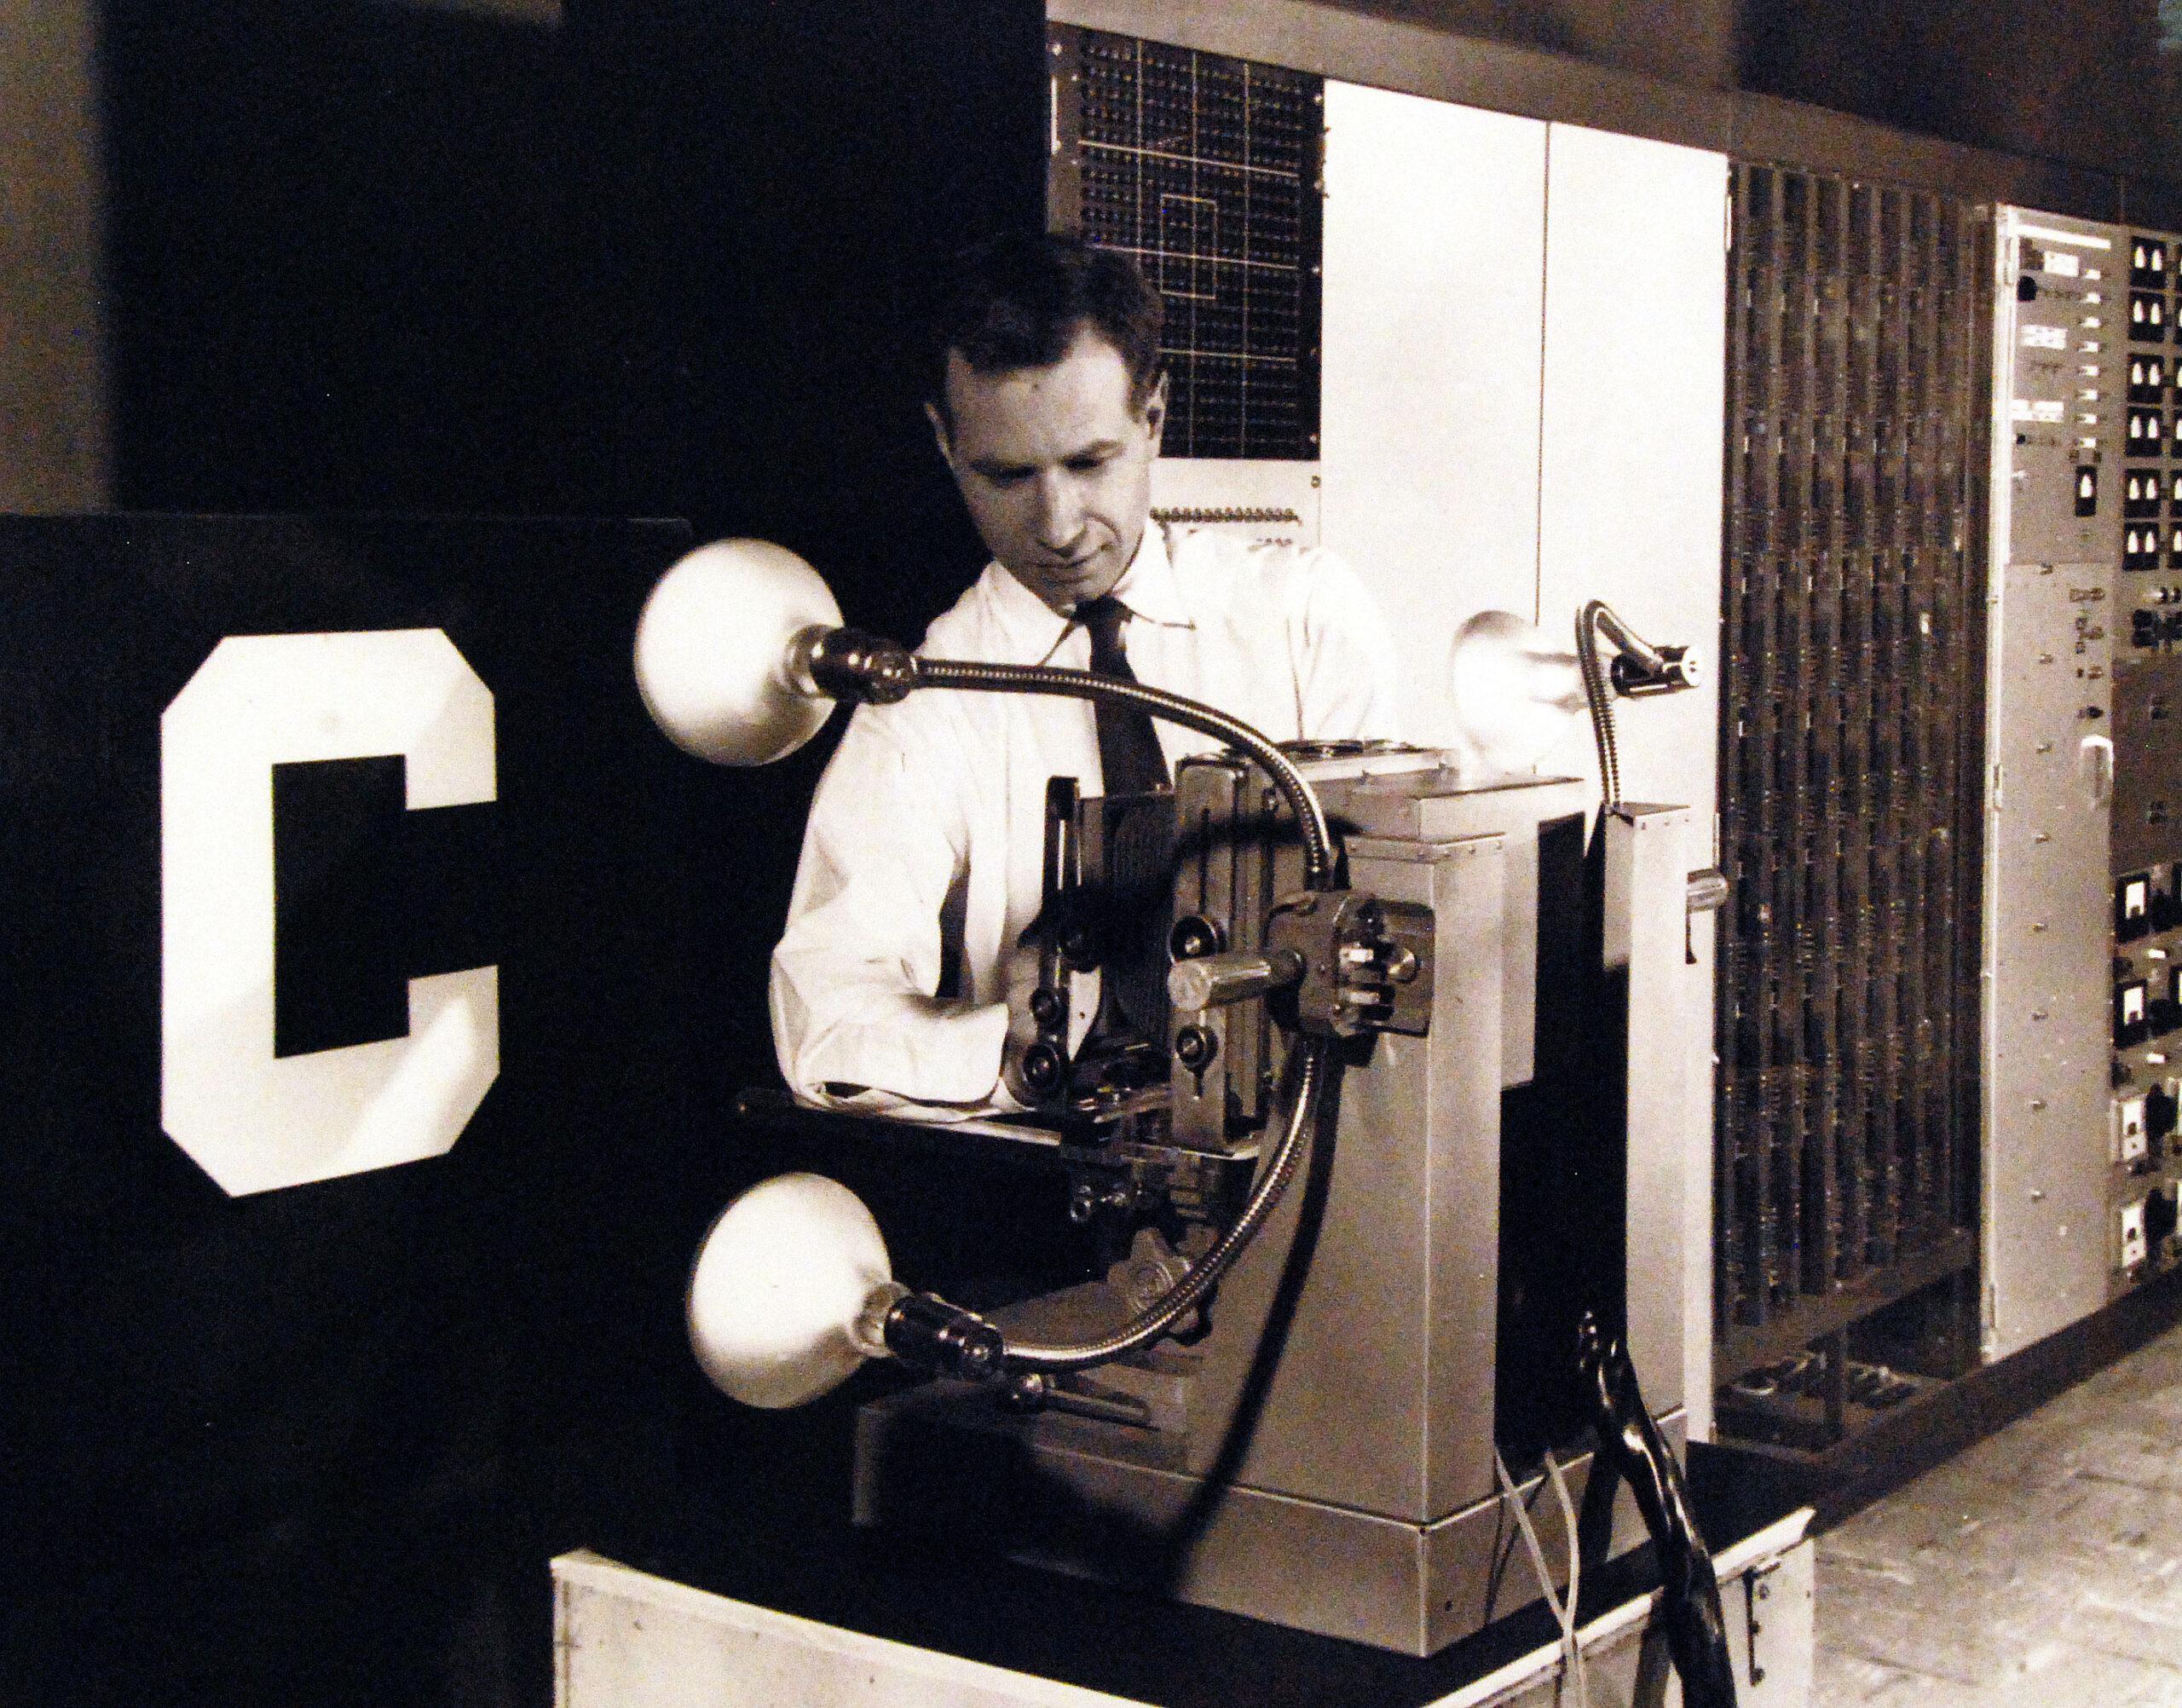
그림 3. Frank Rosenblatt와 초기 Perceptron 장치
Perceptron은 다음 구조를 가집니다.
입력
x1      x2     x3 ...
 │     │     │
w1     w2    w3
 │     │     │
 └──Σ──┘
         │
        Bias
         │
     Activation
         │
       Output
예를 들어 다음과 같이 생각할 수 있습니다.
카메라에서 얻은 특징

x1 = 밝기
x2 = 특정 모양의 존재
x3 = 경계선의 방향
각 입력에는 가중치가 붙습니다.
w1 = 0.2
w2 = 1.3
w3 = -0.5
학습 과정에서는 이 가중치가 계속 수정됩니다.
   예측
    ↓
정답과 비교
    ↓
오차 계산
    ↓
Weight 수정
    ↓
다시 예측
이 과정이 현대 딥러닝 학습의 핵심입니다.
4. Perceptron의 한계와 다층 신경망의 필요성
초기의 단층 Perceptron은 매우 단순한 문제에는 잘 동작했지만 복잡한 문제에는 한계가 있었습니다.
특히 하나의 직선으로 분리할 수 없는 문제를 단층 Perceptron 하나만으로 처리할 수 없습니다.
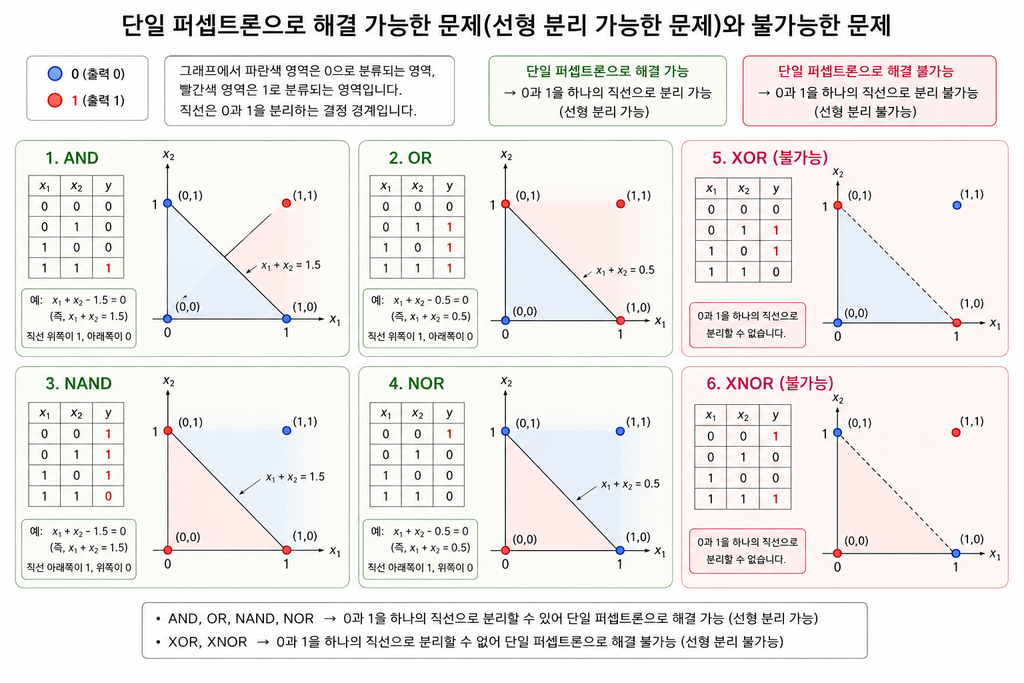
1969년 Marvin Minsky와 Seymour Papert는 저서 Perceptrons에서 이러한 Perceptron 계열 시스템의 계산 능력과 한계를 수학적으로 분석했습니다. MIT Press 역시 이 책이 특정 Perceptron 구조의 한계를 체계적으로 분석했다고 설명합니다.
여기서 중요한 교훈이 나옵니다.
단순한 뉴런 1개
       ↓
복잡한 문제 해결 어려움

여러 뉴런
       ↓
Hidden Layer

여러 Hidden Layer
       ↓
Deep Neural Network
단순한 모델을 여러 층으로 연결해야 더 복잡한 패턴을 표현할 수 있습니다.
5. 인공신경망의 기본 구조
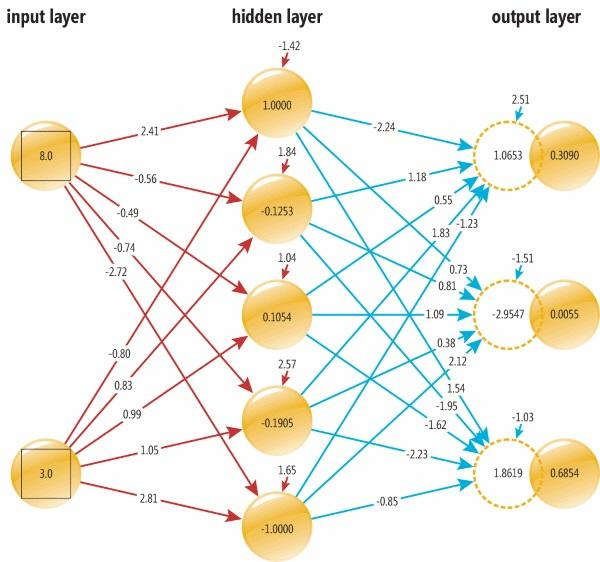
가장 기본적인 인공신경망은 다음 세 종류의 Layer로 구성됩니다.
Input Layer
     ↓
Hidden Layer
     ↓
Output Layer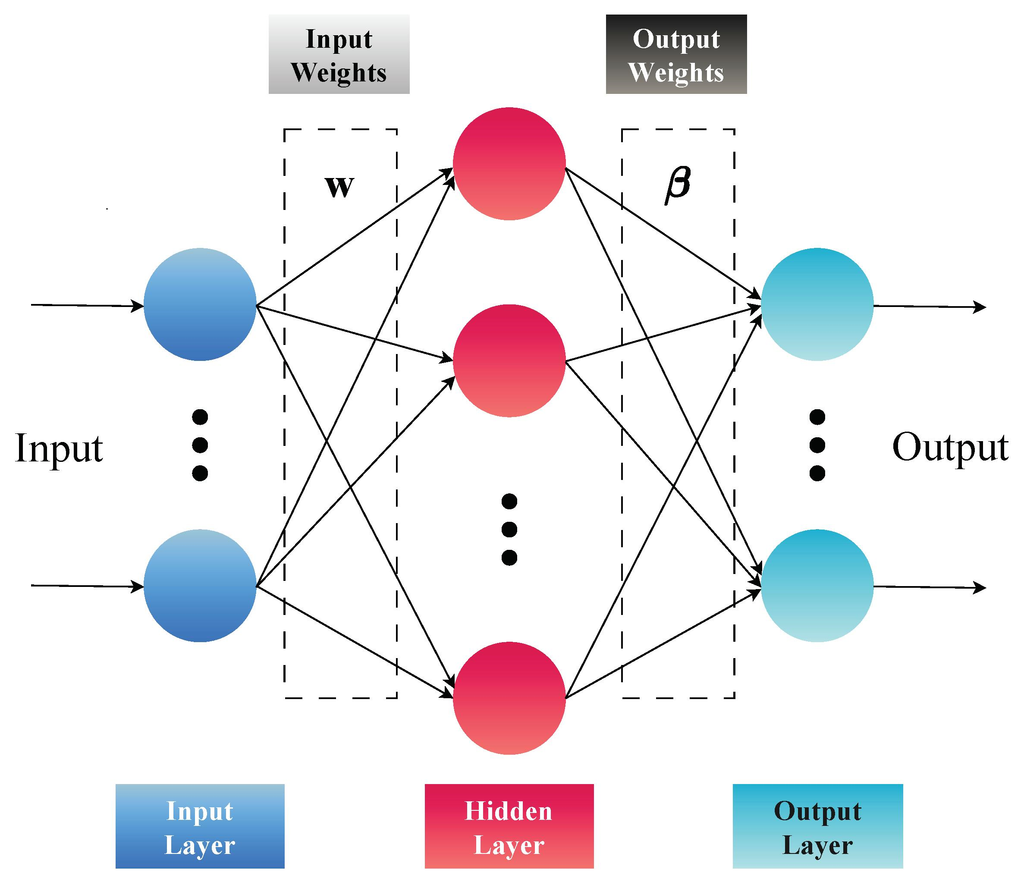
조금 더 커지면 다음과 같습니다.
Input
  ↓
Hidden Layer 1
  ↓
Hidden Layer 2
  ↓
Hidden Layer 3
  ↓
Output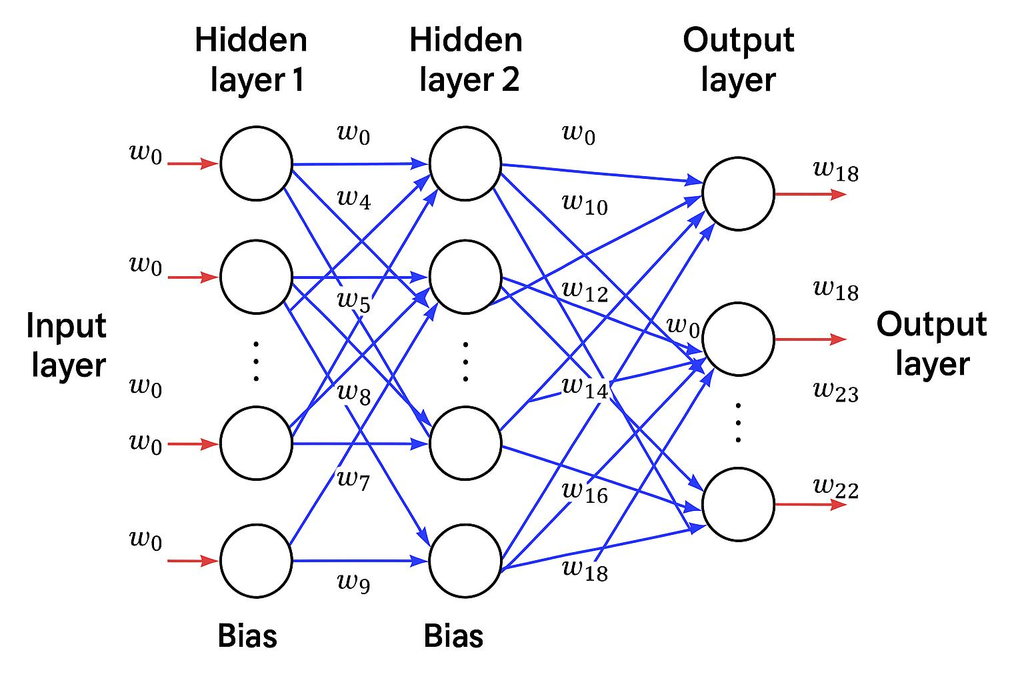

각 원 하나를 뉴런이라고 생각하면 됩니다.
각 연결선에는 Weight가 존재합니다.
결국 신경망을 학습한다는 것은 수많은 Weight와 Bias의 값을 적절하게 찾는 과정입니다.
6. 활성화 함수가 필요한 이유
뉴런에는 활성화 함수가 사용됩니다.
대표적인 함수는 다음과 같습니다.
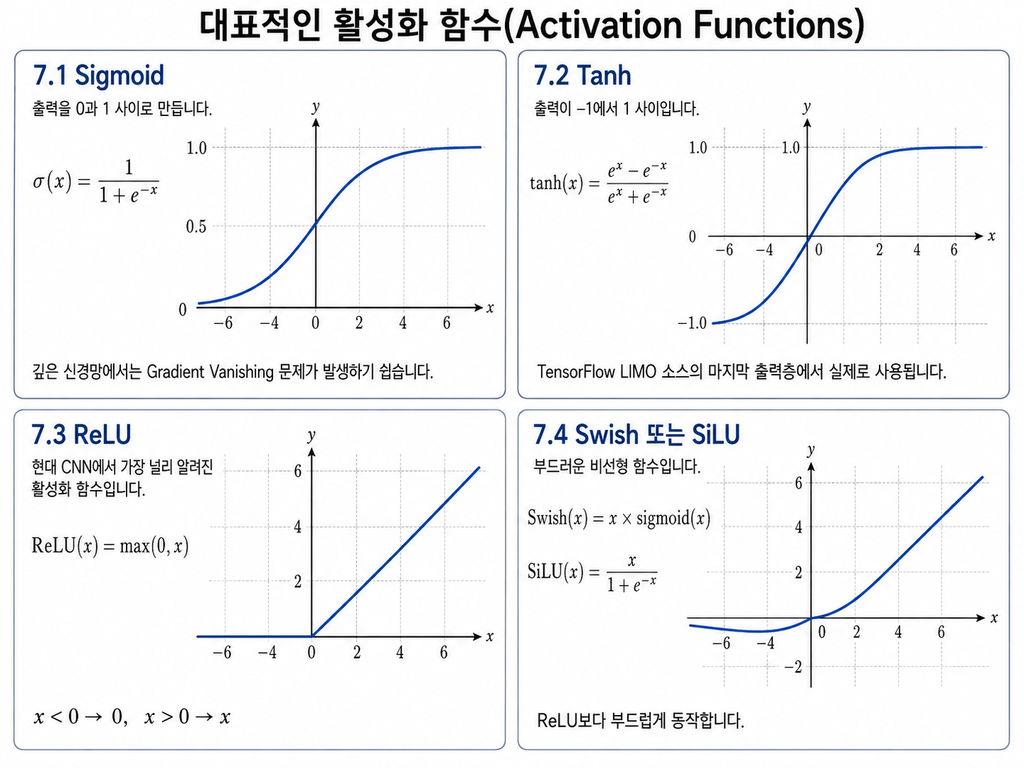
1) Sigmoid
출력을 0과 1 사이로 만듭니다.
과거 신경망에서 많이 사용됐지만 깊은 신경망에서는 Gradient Vanishing 문제가 발생하기 쉽습니다.
2) Tanh
출력이 -1에서 1 사이입니다.
-1 < output < 1LIMO의 TensorFlow 학습 소스의 마지막 출력층에서 실제로 tanh가 사용됩니다.
output = keras.layers.Dense(
    2,
    activation="tanh",
    name="track_output"
)(norm12)
3) ReLU(Rectified Linear Unit; 정류 선형 활성화 함수)
현대 CNN에서 가장 널리 알려진 활성화 함수입니다.
x < 0 → 0
x > 0 → x
4) Swish 또는 SiLU(Sigmoid Linear Unit)
Swish는 다음 개념의 함수입니다.
Swish(x) = x × sigmoid(x)이번 TensorFlow 소스에서는 대부분의 Conv2D와 Dense Layer에서 swish가 사용됩니다.
YOLO 계열에서도 SiLU 계열 활성화가 많이 사용됩니다. 현재 Ultralytics 아키텍처 문서에서도 기본 Conv 블록을 Conv2D → Batch Normalization → SiLU 구조로 설명합니다.
7. 1986년 Backpropagation이 신경망을 다시 살림
다층 신경망에서 가장 큰 문제는 다음이었습니다.
Hidden Layer의 Weight를
어떻게 학습할 것인가?
1986년 David Rumelhart, Geoffrey Hinton, Ronald Williams는 Nature에 Learning representations by back-propagating errors를 발표했습니다.
이 연구는 출력 오차를 뒤쪽 Layer부터 앞쪽 Layer 방향으로 전달하면서 Weight를 조절하는 Backpropagation을 설명했습니다.
학습 흐름은 다음과 같습니다.
Input
 ↓
Forward Propagation
 ↓
Prediction
 ↓
Loss 계산
 ↓
Backward Propagation
 ↓
Gradient 계산
 ↓
Weight Update
이 개념은 현재 TensorFlow와 PyTorch에서도 그대로 사용됩니다.
다만 현재는 개발자가 직접 미분식을 구현하지 않습니다.
예를 들어 Keras에서는 다음 한 줄이 내부적으로 복잡한 역전파 과정을 수행합니다.
model.fit(...)PyTorch 기반 Ultralytics에서도 마찬가지입니다.
model.train(...)8. Loss는 무엇인가
신경망은 자신이 틀렸다는 사실을 숫자로 표현해야 합니다.
이 숫자가 Loss, 손실값입니다.
정답
 ↓
비교 ← 예측
 ↓
Loss
Loss가 작으면 예측이 정답에 가깝다는 의미입니다.
Loss가 크면 많이 틀렸다는 의미입니다.
학습의 궁극적인 목적은 다음과 같습니다.
Loss ↓즉 Loss를 최소화하도록 Weight를 계속 수정합니다.
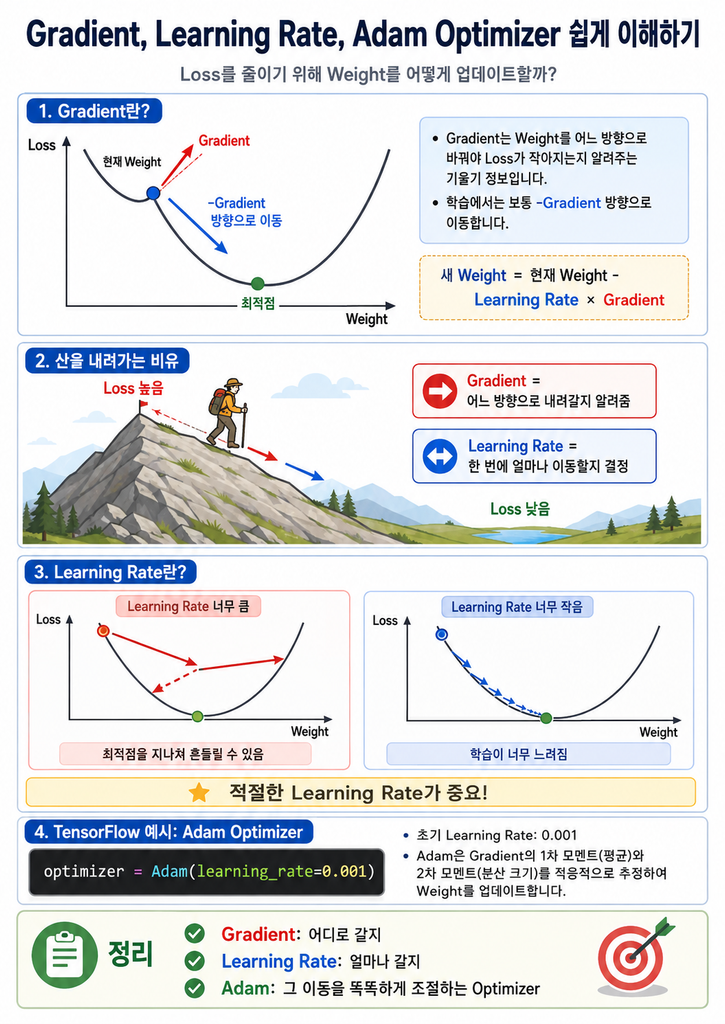
9. Gradient와 Learning Rate
Weight를 어느 방향으로 변경해야 Loss가 작아지는지 알려주는 값이 Gradient입니다.
산을 내려가는 상황으로 생각하면 쉽습니다.
Loss

높음            ●
               /
              /
             ●
            /
           ●
          /
         ●
________________ Weight

낮음
Gradient는 내려가야 할 방향을 알려줍니다.
Learning Rate는 한 번에 얼마나 이동할지를 결정합니다.
Learning Rate 너무 큼
→ 최적점을 지나칠 수 있음

Learning Rate 너무 작음
→ 학습이 지나치게 느림
TensorFlow 학습 소스는 Adam Optimizer와 초기 Learning Rate 0.001을 사용합니다.
TensorFlow 문서에서도 Adam은 Gradient의 1차·2차 모멘트를 적응적으로 추정하는 최적화 방법으로 설명합니다.
10. Epoch와 Batch
딥러닝 코드를 읽을 때 반드시 알아야 하는 개념입니다.
1) Epoch
전체 학습 데이터를 한 번 학습하면 1 Epoch입니다.
데이터가 1,000장이라면
1 Epoch = 1,000장을 한 번 학습100 Epoch이면 같은 학습 데이터 전체를 100번 반복하여 학습합니다.
2) Batch
1,000장의 이미지를 한 번에 GPU에 넣는 것은 효율적이지 않습니다.
예를 들어 Batch Size를 32로 하면 다음과 같이 처리합니다.
32장
 ↓
학습

다음 32장
 ↓
학습

다음 32장
 ↓
학습
TensorFlow LIMO 학습 소스에서는 다음과 같이 되어 있습니다.
epochs=1000
batch_size=32
하지만 실제로 무조건 1000 Epoch까지 학습하지는 않습니다. EarlyStopping이 있기 때문입니다.
11. 1980~1990년대 CNN의 등장
일반적인 Fully Connected Neural Network에서는 모든 뉴런이 연결됩니다.
이미지처럼 데이터가 매우 큰 경우 연결 수가 폭발합니다.
예를 들어 RGB 영상 하나만 해도
300 × 300 × 3
= 270,000 values
입니다.
이 문제를 해결하는 매우 중요한 구조가 CNN, Convolutional Neural Network입니다.
1980년 Kunihiko Fukushima는 위치 변화에 강한 계층적 시각 인식 모델인 Neocognitron을 제안했습니다.
1989년 Yann LeCun 연구진은 Backpropagation 기반 네트워크를 미국 우편번호 손글씨 인식 문제에 적용했습니다.
1998년 LeCun, Bottou, Bengio, Haffner의 연구에서는 CNN을 이용한 문서 인식 시스템이 정리되었습니다.
이 계열의 구조가 현재 카메라 기반 딥러닝의 직접적인 조상이라고 볼 수 있습니다.
12. CNN이 이미지를 보는 방법
사람이 사진을 보면 바로 자동차라고 생각합니다.
CNN은 조금 다르게 처리합니다.
초기 Layer에서는 매우 단순한 특징을 찾습니다.
Layer 1
 ↓
가로선
세로선
모서리
밝기 변화
조금 깊은 Layer에서는
Layer 2
 ↓
곡선
모서리 조합
작은 패턴
더 깊어지면
Layer 3
 ↓
바퀴
창문
표지판 형태
마지막에는
자동차
사람
표지판
같은 고수준 특징을 표현할 수 있습니다.
이것이 딥러닝의 핵심적인 특징 중 하나인 Feature Hierarchy입니다.
13. Convolution이란 무엇인가
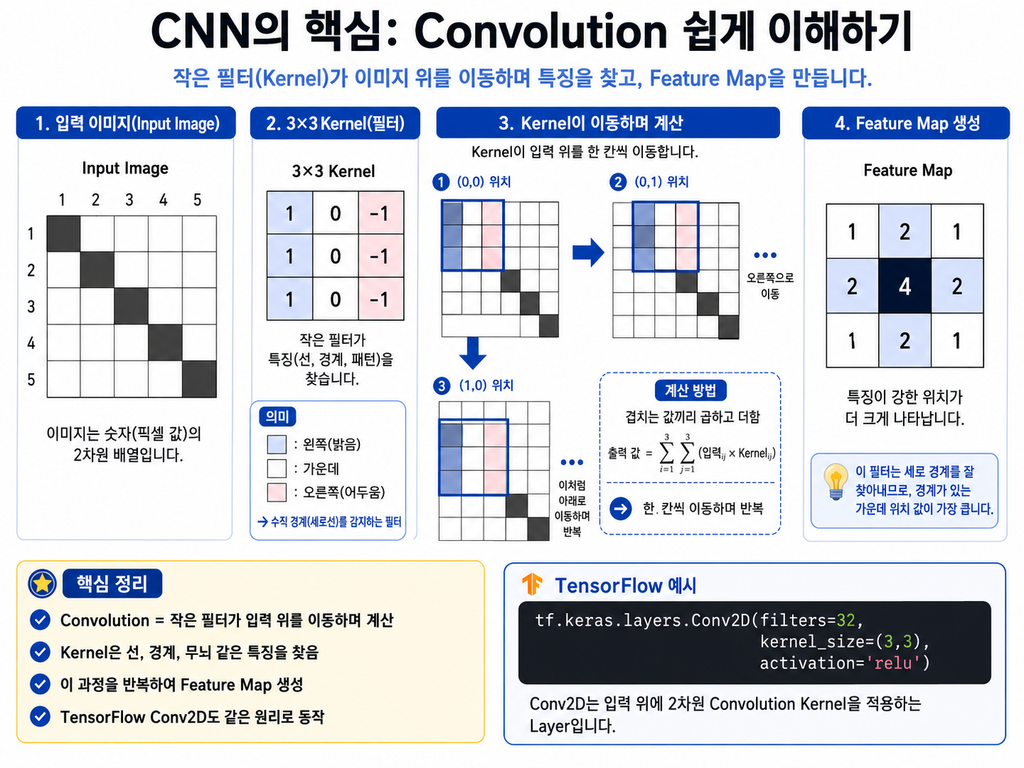
CNN의 핵심은 Convolution입니다.
작은 필터가 이미지 위를 이동하면서 특징을 찾습니다.
예를 들어 3×3 Filter가 있다고 하겠습니다.
Input Image

□ □ □ □ □
□ □ □ □ □
□ □ □ □ □
□ □ □ □ □
□ □ □ □ □

3 × 3 Kernel

■ ■ ■
■ ■ ■
■ ■ ■
Kernel이 이동합니다.
[■ ■ ■] □ □
[■ ■ ■] □ □
[■ ■ ■] □ □
 □ □ □  □ □
 □ □ □  □ □
그리고 다음 위치로 이동합니다.
이 과정을 반복하면서 Feature Map을 생성합니다.
TensorFlow의 Conv2D 역시 입력 위에 2차원 Convolution Kernel을 적용하는 Layer입니다.
14. Filter와 Feature Map
CNN 코드에서 다음과 같은 표현을 자주 만납니다.
Conv2D(32, (3, 3))32는 Filter 개수입니다.
(3, 3)은 Kernel 크기입니다.
즉
3×3 필터 32개를 학습합니다.
각 Filter는 서로 다른 특징을 찾을 수 있습니다.
Filter 1 → 세로선
Filter 2 → 가로선
Filter 3 → 대각선
Filter 4 → 밝기 변화
...
실제로 어떤 패턴을 학습할지는 사람이 지정하지 않습니다.
학습을 통해 Weight가 결정됩니다.
15. Pooling은 무엇인가
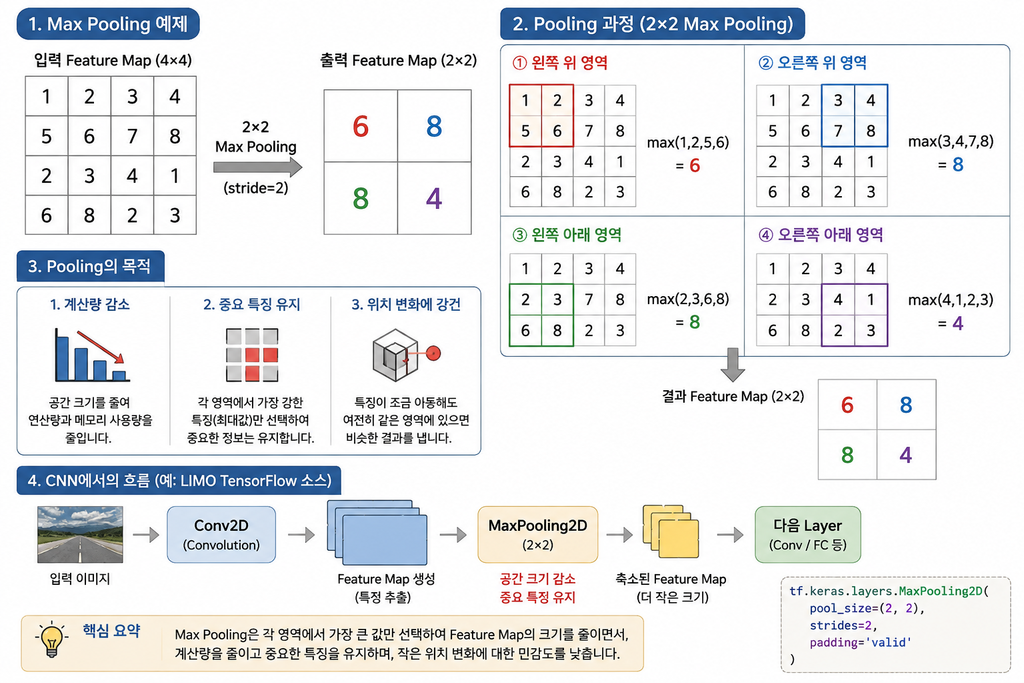
Pooling은 영상의 특징 맵 크기를 줄입니다.
예를 들어
4 × 4

1 2 3 4
5 6 7 8
2 3 4 1
6 8 2 3
2×2 Max Pooling을 사용하면 각 영역에서 가장 큰 값을 선택합니다.
결과적으로 공간 크기를 줄일 수 있습니다.
Pooling의 목적은 크게 다음과 같습니다.
- 계산량 감소
- 중요 특징 유지
- 작은 위치 변화에 대한 민감도 감소
LIMO TensorFlow 소스에서도 초반에 MaxPooling2D가 사용됩니다.
16. Batch Normalization
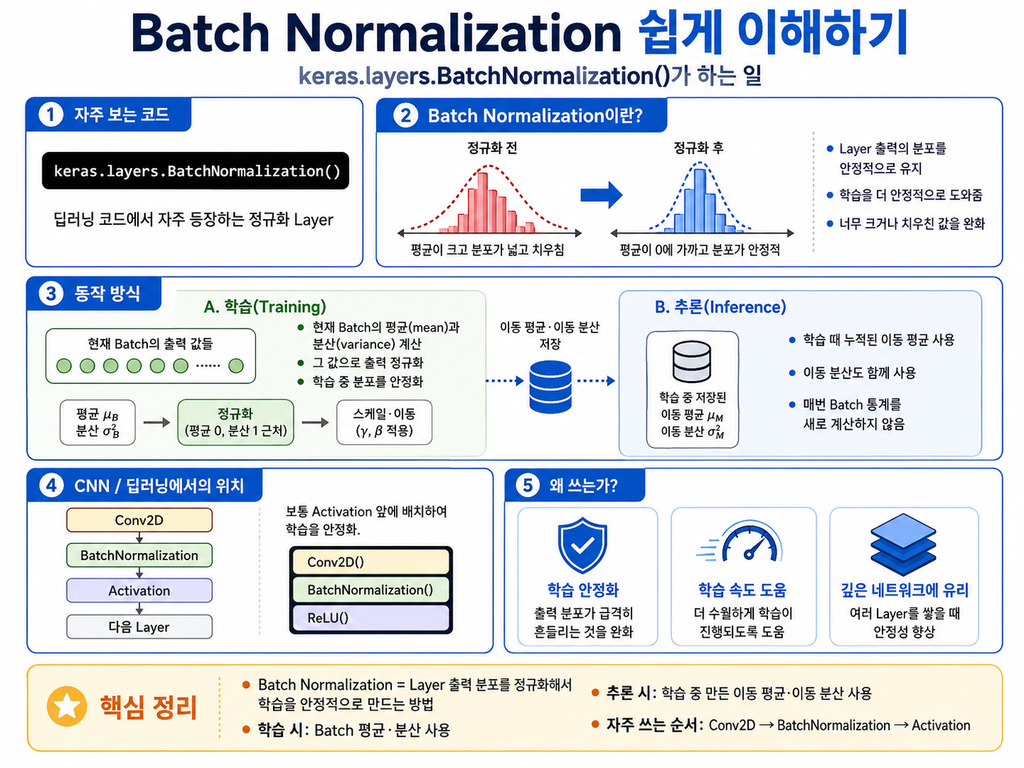
딥러닝 프로그램에서 가장 자주 보이는 코드 중 하나가 다음입니다.
keras.layers.BatchNormalization()Batch Normalization은 Layer 출력의 분포를 안정적으로 유지하도록 도와주는 방법입니다.
TensorFlow 공식 문서에서는 학습 중 입력의 Batch 평균과 분산을 이용하여 정규화하며, 추론 시에는 학습 과정에서 만들어진 이동 평균 값을 사용한다고 설명합니다.
초급 과정에서는 다음 정도로 이해하면 충분합니다.
Conv2D
 ↓
BatchNormalization
 ↓
Activation
 ↓
다음 Layer
목적은 학습을 더 안정적으로 만드는 것입니다.
17. Residual Connection
TensorFlow LIMO 모델에서 다음 코드가 등장합니다.
add1 = keras.layers.Add()([norm2, norm3])비슷한 구조가 여러 번 사용됩니다.
Input ──────────────┐
  ↓                                            │
Conv                                          │
  ↓                                            │
BN                                             │
  ↓                                            │
  └──────── Add ←────┘
이러한 Skip 또는 Residual Connection은 깊은 신경망에서 정보와 Gradient가 전달되기 쉽게 하는 매우 중요한 구조입니다.
이번 모델은 완전한 ResNet 모델은 아니지만 비슷한 Residual 개념을 일부 사용하고 있다고 이해하면 됩니다.

18. 2006년 현대 딥러닝의 재출발
딥러닝의 탄생 시점을 하나의 연도로 정확히 정하는 것은 어렵습니다.
신경망 자체는 1940년대부터 있었고 Backpropagation도 1980년대에 널리 알려졌습니다.
하지만 Deep Learning의 현대적 부활을 설명할 때 2006년은 매우 중요한 시점입니다.
Geoffrey Hinton, Simon Osindero, Yee-Whye Teh는 2006년 A Fast Learning Algorithm for Deep Belief Nets를 발표했습니다. 깊은 네트워크를 Layer 단위로 효과적으로 학습하는 방법을 제시했습니다.
같은 해 Hinton과 Salakhutdinov는 깊은 Autoencoder를 이용한 고차원 데이터의 차원 축소 연구도 발표했습니다.
큰 흐름만 보면 아래와 같습니다.
1943
인공 뉴런 개념

1950년대
Perceptron과 학습

1980년대
Backpropagation + CNN

2006
Deep Network 연구 부활

2012
Deep Learning 대중화 폭발
19. 2009년 ImageNet이 데이터 제공
딥러닝이 성공하려면 신경망만 좋아서는 안 됩니다.
세 가지 요소가 함께 필요합니다.
Algorithm
+
Data
+
Computing Power
2009년 Jia Deng, Li Fei-Fei 연구진은 대규모 이미지 데이터베이스 ImageNet을 발표했습니다.
당시 발표된 ImageNet은 5,247개의 synset과 약 320만 장의 정제된 이미지를 포함하는 대규모 데이터베이스였습니다.
이후 ImageNet Large Scale Visual Recognition Challenge는 이미지 인식 알고리즘을 비교하는 중요한 기준이 됩니다.
20. 2012년 AlexNet과 딥러닝 붐
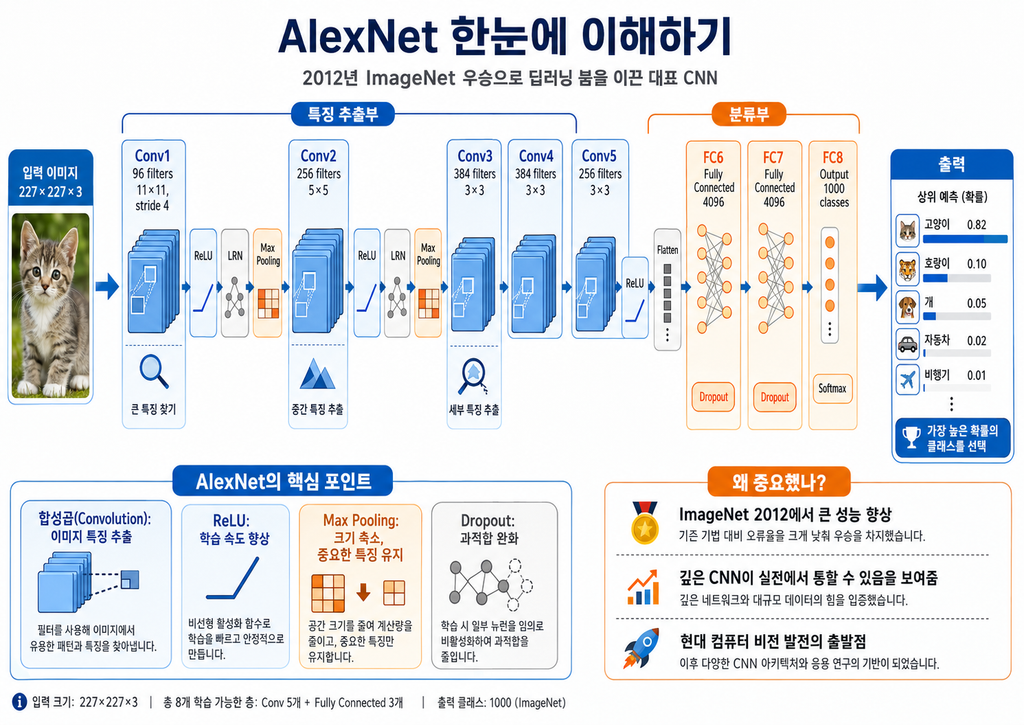
2012년 Alex Krizhevsky, Ilya Sutskever, Geoffrey Hinton이 발표한 AlexNet은 딥러닝 역사에서 결정적인 사건입니다.
AlexNet은 대규모 CNN을 GPU로 학습하고 ReLU와 Dropout 등을 사용하여 ImageNet 이미지 분류에서 당시 기존 방법보다 크게 향상된 결과를 보였습니다. 논문의 네트워크는 약 6천만 개의 Parameter를 갖는 대규모 CNN이었습니다.
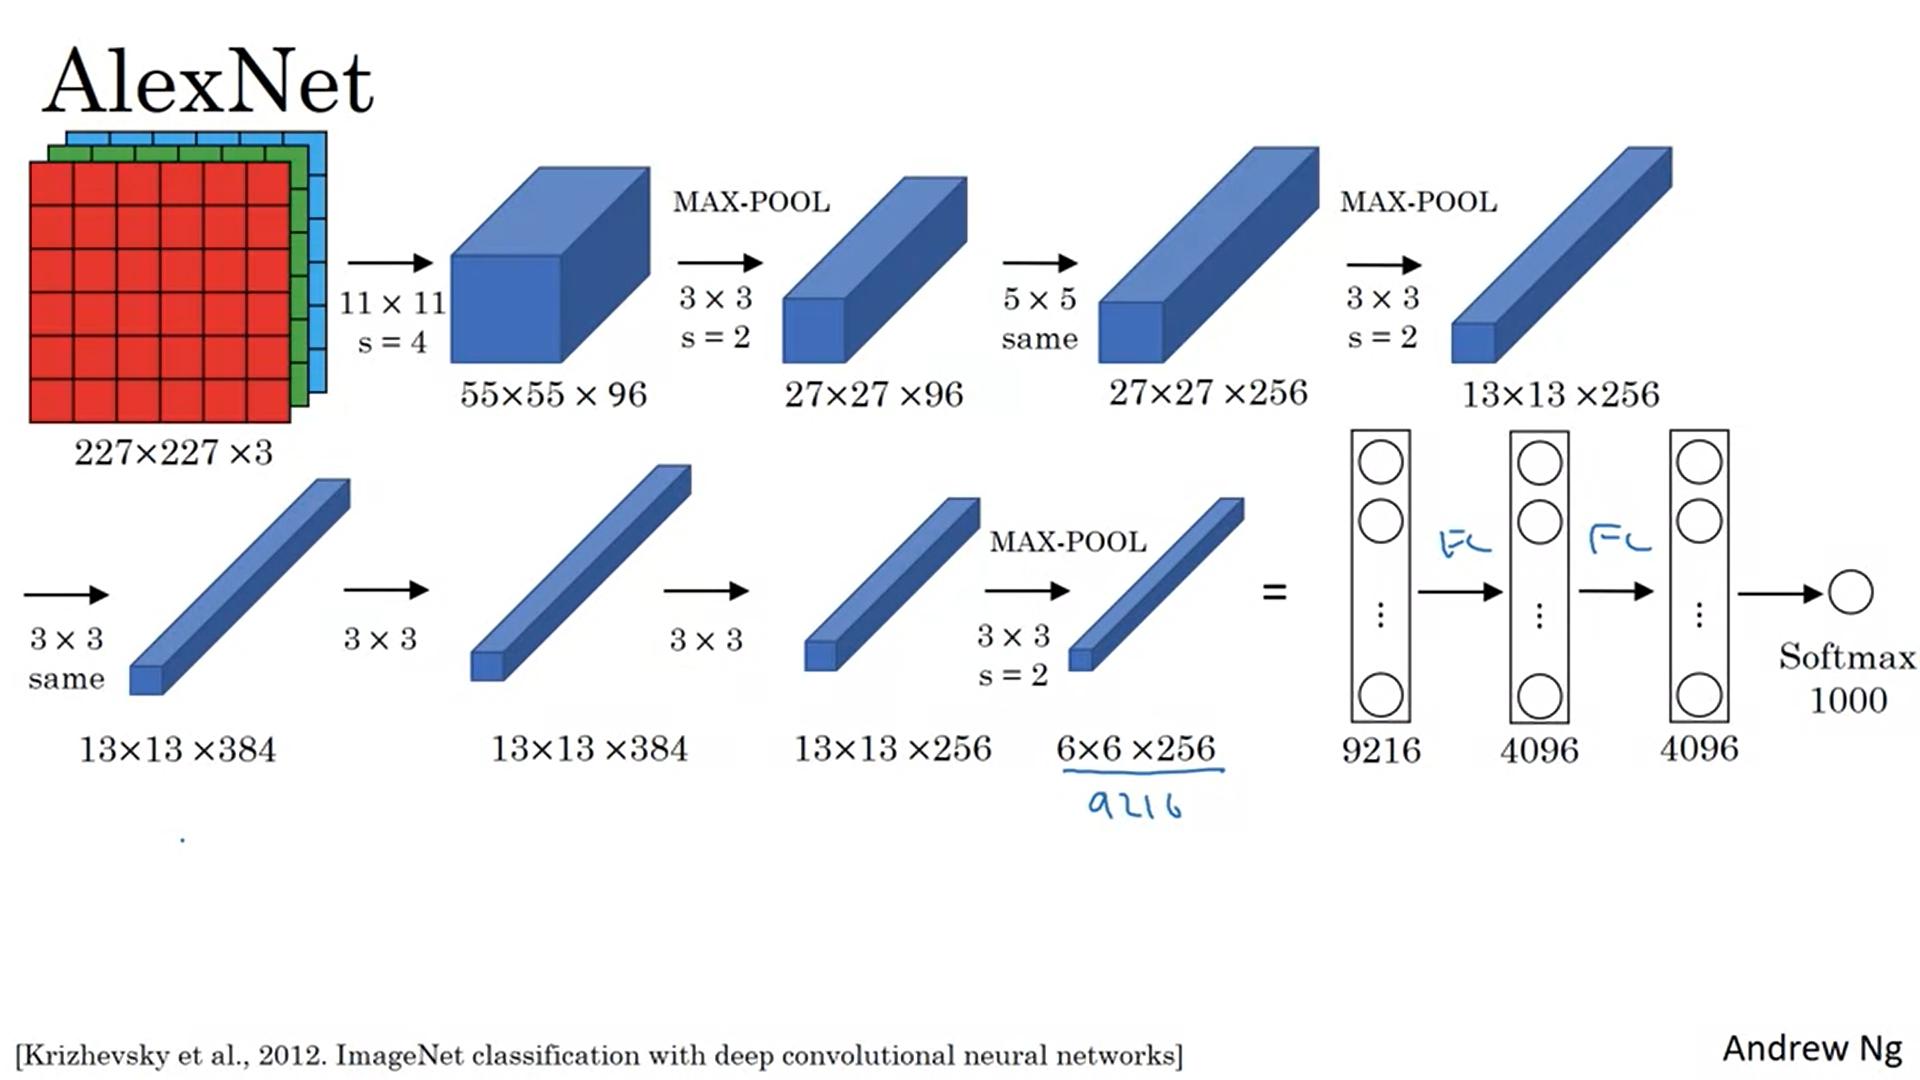
그림 4. AlexNet의 대표적인 CNN 구조
이 사건 이후 다음 조건이 서로 맞아떨어집니다.
대규모 데이터
     +
GPU
     +
CNN
     +
Backpropagation
     +
좋은 학습 기법
     ↓
Deep Learning 급성장
현재 로봇에서 사용하는 카메라 기반 딥러닝 역시 이 흐름의 연장선입니다.
21. 신경망과 딥러닝의 차이
가장 단순하게 설명하면 다음과 같습니다.
Neural Network

Input
 ↓
Hidden
 ↓
Output
딥러닝은
Deep Neural Network

Input
 ↓
Hidden
 ↓
Hidden
 ↓
Hidden
 ↓
Hidden
 ↓
Hidden
 ↓
Output
처럼 여러 계층을 사용합니다.
하지만 단순히 Layer 개수가 많다고 좋은 모델이 되는 것은 아닙니다.
Layer가 많아질수록
학습 데이터
계산량
GPU
Gradient
Overfitting
Normalization
Architecture
등을 함께 고려해야 합니다.
22. 로봇 Vision에서 사용하는 대표적인 딥러닝 문제
로봇 카메라에서 딥러닝을 적용할 때 다음 문제들을 구분할 수 있어야 합니다.
1) Classification
이미지 전체가 무엇인지 판단합니다.
Image
 ↓
CNN
 ↓
cat
2) Regression
연속적인 숫자를 예측합니다.
Image
 ↓
CNN
 ↓
0.32, -0.18
LIMO에서 사용하는 TensorFlow Track Detection 소스가 이 유형에 해당합니다.
정확히는 모델이 이미지로부터 두 개의 연속값을 출력하는 CNN 회귀 구조입니다. Notebook 자체에서는 두 값의 실제 물리적 의미를 별도로 정의하지 않고 파일명에서 추출한 value1, value2를 학습 대상으로 사용합니다. 따라서 강의에서는 이를 임의로 조향각이라고 단정하기보다 파일명에 기록된 두 개의 Track 관련 목표값이라고 설명하는 것이 정확합니다.
3) Object Detection
객체 종류뿐 아니라 위치까지 찾습니다.
Image
 ↓
Detector
 ↓
Class + Bounding Box
YOLO가 대표적입니다.
4) Semantic Segmentation
영상의 각 Pixel이 어떤 클래스인지 판단합니다.
road
person
wall
floor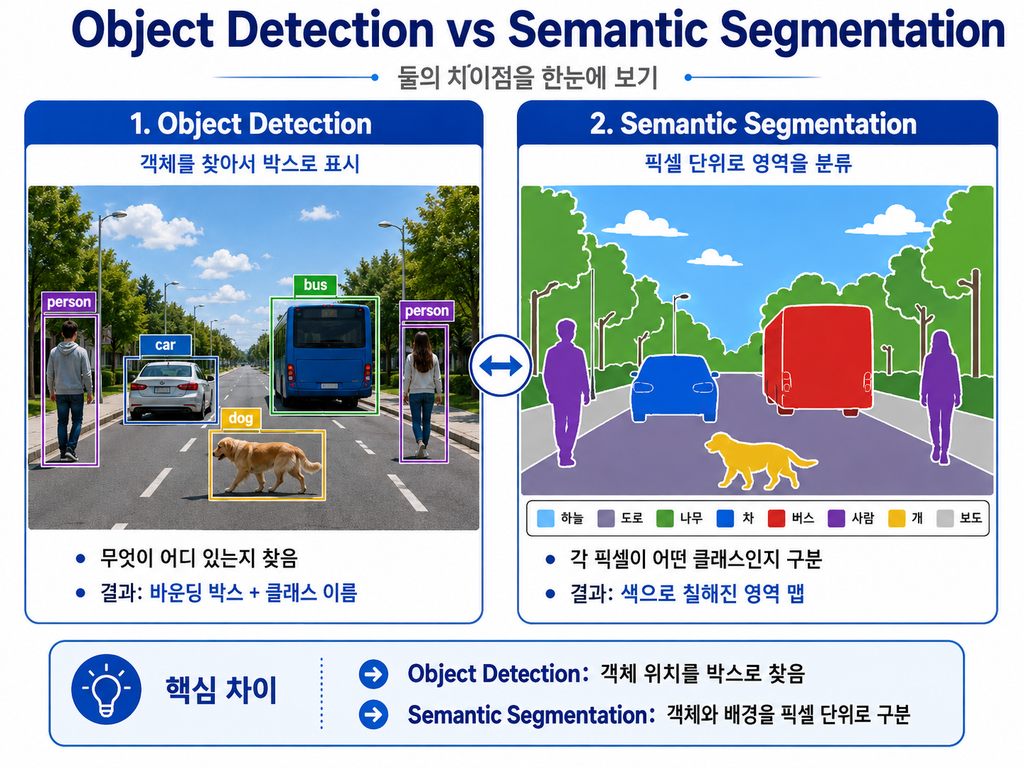
5) Pose Estimation
사람이나 객체의 주요 Keypoint 위치를 찾습니다.
현재 Ultralytics YOLO 계열은 Detection 외에도 Classification, Segmentation, Pose, OBB(Oriented Bounding Box) 등의 작업을 지원합니다.
23. 2015년 YOLO의 등장
기존 객체검출 알고리즘은 여러 단계로 처리하는 경우가 많았습니다.
YOLO는 객체검출 문제를 하나의 Neural Network가 직접 처리하도록 만들었습니다.
Joseph Redmon 등의 YOLO 논문 제목은 You Only Look Once: Unified, Real-Time Object Detection입니다.
YOLO는 하나의 전체 이미지에서 Bounding Box와 Class Probability를 한 번의 Neural Network 평가로 예측하도록 설계되었습니다. 초기 YOLO 논문에서도 객체검출을 하나의 Regression 문제로 다룬다는 점을 강조합니다.
개념적으로 다음과 같습니다.
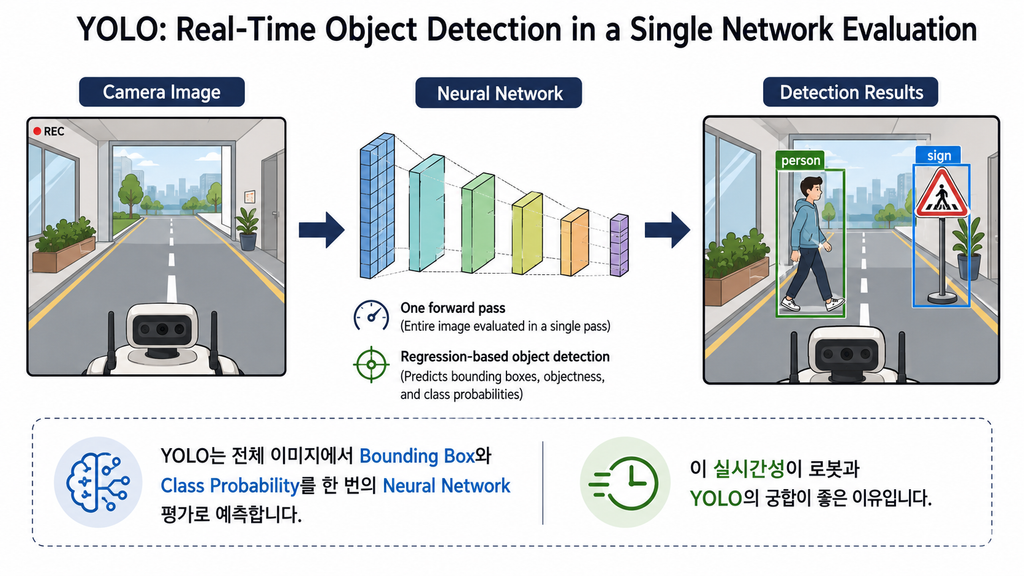
이러한 실시간성이 로봇과 YOLO의 궁합이 좋은 이유입니다.
24. YOLO의 기본 구조
현대 Ultralytics YOLO 모델은 크게 다음 구조로 이해하면 됩니다.
Input Image
    ↓
Backbone
    ↓
Neck
    ↓
Head
    ↓
Bounding Box + Class
Ultralytics의 현재 공식 아키텍처 문서에서도 YOLO를 Backbone → Neck → Head의 세 단계로 설명합니다.
1) Backbone
영상에서 특징을 추출합니다.
edge
texture
shape
object feature
2) Neck
여러 크기의 Feature Map을 결합합니다.
작은 객체와 큰 객체를 동시에 잘 찾기 위해 필요합니다.
3) Head
최종적으로 다음 정보를 예측합니다.
Class
Bounding Box
Confidence
YOLO11에서는 C3k2, SPPF, C2PSA 등의 구조가 사용되며, 현재 Ultralytics 문서는 YOLO11을 Anchor-Free Detection Head 구조로 설명합니다.
요약하면 아래와 같습니다.
Backbone
특징 추출

Neck
특징 결합

Head
객체 위치와 종류 예측
26. Bounding Box
YOLO를 이해하려면 Bounding Box가 반드시 필요합니다.
객체가 다음 영역에 있다고 하겠습니다.
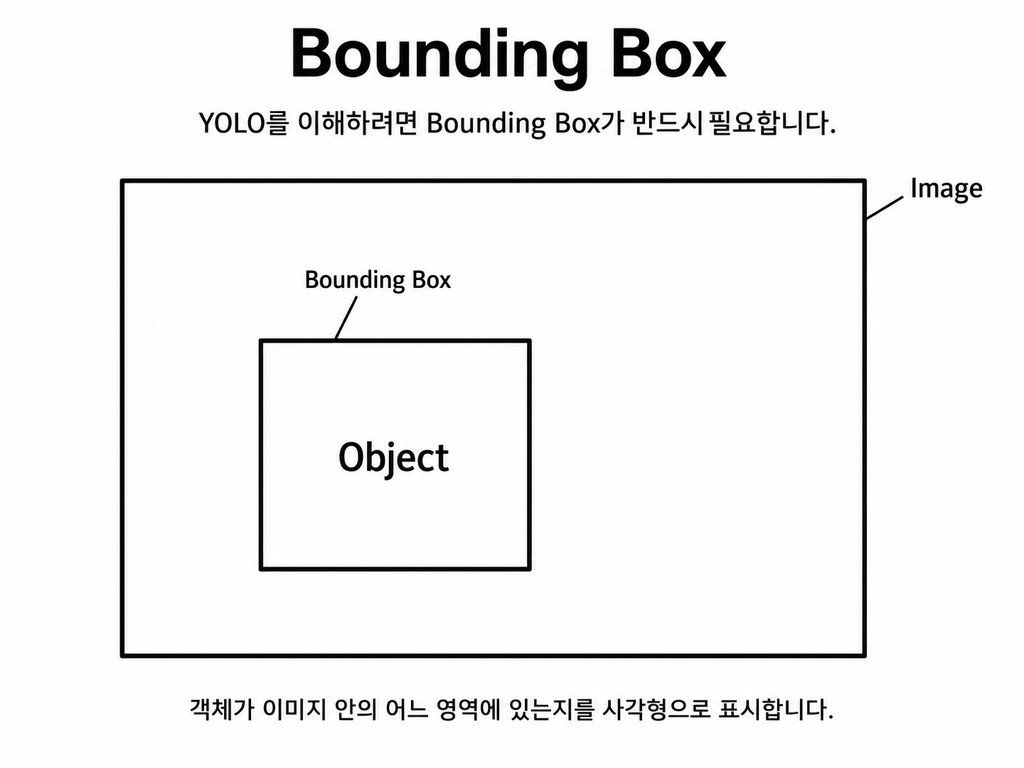
YOLO에서는 일반적으로 다음 값을 사용합니다.
x_center
y_center
width
height
Ultralytics YOLO Detection Dataset의 Label은 다음 형식입니다.
class_id x_center y_center width height좌표는 Pixel 값이 아니라 영상 크기에 대해 0~1로 정규화된 값을 사용합니다. Class ID는 0부터 시작합니다.
예를 들어
2 0.52 0.41 0.20 0.18이라면
class = 2
center x = 0.52
center y = 0.41
width = 0.20
height = 0.18
이라는 의미입니다.
26. IoU(Intersection over Union)
객체검출에서는 예측 Bounding Box와 실제 정답 Bounding Box가 얼마나 겹치는지 평가해야 합니다.
대표적인 지표가 IoU입니다.
            교집합
IoU = -------------------
            합집합
완전히 일치하면
IoU = 1전혀 겹치지 않으면
IoU = 0입니다.
27. Precision과 Recall
Object Detection 결과를 평가할 때 자주 등장합니다.
Precision은
모델이 있다고 판단한 것 중
실제로 맞은 비율
Recall은
실제로 존재하는 객체 중
모델이 찾아낸 비율
입니다.
예를 들어 표지판이 10개 있는데 모델이 8개를 찾았다면 Recall이 떨어질 수 있습니다.
반대로 아무 물체도 없는 곳에 계속 표지판이 있다고 잘못 판단하면 Precision이 떨어집니다.
28. mAP
YOLO 학습 결과에서 매우 중요하게 봐야 하는 값입니다.
mAP = mean Average Precision단순 Accuracy 하나로 객체검출을 평가하기 어렵기 때문에 Precision과 Recall, IoU 기준 등을 종합적으로 평가합니다.
아래의 값의 차이는 IoU 기준을 얼마나 엄격하게 적용하느냐입니다.
mAP50
= IoU 0.50 기준에서 계산한 mAP

mAP50-95
= IoU 0.50부터 0.95까지 여러 기준에서 계산한 mAP의 평균
mAP50은 검출 성공 여부를 비교적 관대하게 평가하고, mAP50-95는 Bounding Box 위치 정확도까지 엄격하게 평가하는 지표입니다.
29. YOLO11의 n은 무엇인가
yolo11n.pt의 n은 Nano 계열을 의미합니다.
교육용 모바일 로봇에서는 매우 합리적인 선택입니다.
로봇은 Cloud Server가 아니라 제한된 CPU/GPU 환경에서 실시간 추론해야 하기 때문입니다.
일반적인 방향은
작은 모델
→ 빠름
→ 상대적으로 정확도 낮을 수 있음

큰 모델
→ 느림
→ 상대적으로 높은 정확도 가능
입니다.
항상 가장 큰 모델이 로봇에 좋은 것은 아닙니다.
30. GPU와 CUDA
두 Notebook 모두 GPU를 확인합니다.
TensorFlow Notebook에서는
tf.config.list_physical_devices("GPU")를 사용하고
YOLO Notebook에서는
torch.cuda.is_available()을 사용합니다.
CUDA는 NVIDIA GPU를 이용해 딥러닝 학습과 추론을 가속하는 기술입니다. 즉 CUDA는 NVIDIA GPU를 딥러닝 연산에 사용할 수 있게 해주는 기술입니다.
GPU가 필요한 이유는 Neural Network의 계산 대부분이 대량의 행렬 연산이기 때문입니다.
CPU

몇 개의 강력한 Core

GPU

수천 개 수준의 병렬 연산 Unit
이미지 Deep Learning에서는 GPU가 매우 유리합니다.
31. Docker를 사용하는 이유
Deep Learning을 작업할 때 가장 자주 발생하는 문제가 Python 코드 자체가 아닙니다.
다음과 같은 버전 문제입니다.
Python
TensorFlow
PyTorch
CUDA
cuDNN
NumPy
OpenCV
Ultralytics
Docker는 이 실행 환경을 Container 안에 고정할 수 있습니다.
Host Ubuntu
     ↓
Docker
     ↓
TensorFlow Container
또는
Host Ubuntu
     ↓
Docker
     ↓
Ultralytics Container
처럼 사용합니다.
TensorFlow Notebook 역시 Container 실행 중 TensorFlow나 NumPy 핵심 패키지를 다시 설치하지 않고 Docker 이미지 단계에서 호환 조합을 유지하도록 작성되어 있습니다.
32. Docker Volume
Container 내부 파일은 Container가 삭제되면 사라질 수 있습니다.
따라서
-v "$PWD:/workspace"처럼 Host 폴더를 Container의 /workspace에 연결합니다.
개념적으로
Host PC

/home/user/limo
       │
       │ volume
       ↓
Docker

/workspace
입니다.
Dataset과 학습 결과를 Host에 보존할 수 있습니다.
33. NumPy에서 반드시 이해해야 하는 Shape
딥러닝에서 가장 자주 발생하는 오류 중 하나는 Shape 오류입니다.
예를 들어
Image
(110, 300, 3)
여러 장을 묶으면
Batch
(32, 110, 300, 3)
가 됩니다.
TensorFlow에서 일반적인 이미지 Tensor는
Batch
Height
Width
Channel
순서입니다.
학생들이 코드에서 가장 먼저 확인해야 하는 습관은 이것입니다.
print(img.shape)
print(label.shape)
34. OpenCV와 Deep Learning의 관계
OpenCV 자체가 곧 딥러닝은 아닙니다.
프로그램에서는 OpenCV가 주로 다음 역할을 합니다.
Image Load
ROI Crop
Image Processing
딥러닝은 TensorFlow 또는 PyTorch가 담당합니다.
로봇에서는 보통 함께 사용합니다.
ROS Image
 ↓
cv_bridge
 ↓
OpenCV
 ↓
Preprocessing
 ↓
Deep Learning
 ↓
OpenCV Visualization
35. ROS 2와 TensorFlow를 연결하면
실제 로봇에서는 학습 Notebook을 그대로 실행하지 않습니다.
학습과 추론을 분리해야 합니다.
PC 또는 GPU Server

Dataset
 ↓
Training
 ↓
dl_drive.h5
완성된 모델을 LIMO에 복사합니다.
LIMO

Camera Topic
 ↓
ROS 2 Node
 ↓
OpenCV
 ↓
dl_drive.h5
 ↓
Prediction
 ↓
Driving Control
즉 Training과 Inference는 서로 다른 단계입니다.
36. ROS 2와 YOLO를 연결하면
YOLO도 동일합니다.
Training PC

Dataset
 ↓
YOLO11 Training
 ↓
best.pt
로봇에서는
Camera
 ↓
/camera/image_raw
 ↓
YOLO Node
 ↓
best.pt
 ↓
Detection
 ↓
Class + Bounding Box
 ↓
Robot Decision
예를 들어
speed_up 검출
 ↓
속도 증가

slow_down 검출
 ↓
속도 감소

turn_right 검출
 ↓
우회전 상태 전환
같은 로직으로 연결할 수 있습니다.
여기부터는 이미 학습한 ROS 2 State Machine 또는 Control Node와 자연스럽게 연결할 수 있습니다.
37. 딥러닝과 로봇 제어를 직접 연결할 때 주의할 점
다음 구조는 위험합니다.
딥러닝 출력
 ↓
즉시 Motor Command
실제 로봇에서는 중간에 판단 로직을 두는 것이 좋습니다.
Deep Learning
 ↓
Confidence Check
 ↓
Temporal Filtering
 ↓
Safety Condition
 ↓
State Machine
 ↓
Velocity Command
예를 들어 YOLO가 한 Frame에서 turn_right를 잘못 검출했다고 즉시 우회전해서는 안 됩니다.
최근 N Frame에서
반복 검출되는가?

Confidence가 충분한가?

LiDAR 장애물은 없는가?

현재 주행 State와 일치하는가?
를 함께 판단하는 것이 좋습니다.
로봇에서 AI는 센서를 대체하는 절대적인 판단자라기보다 하나의 고급 인지 Sensor처럼 취급하는 것이 안전합니다.
38. 전통적인 Computer Vision과 Deep Learning 비교
전통적인 영상처리는 사람이 Feature를 설계합니다.
Camera
 ↓
Grayscale
 ↓
Threshold
 ↓
Edge Detection
 ↓
Contour
 ↓
Rule
 ↓
Decision
딥러닝에서는
Camera
 ↓
Neural Network
 ↓
Learned Feature
 ↓
Decision
방식입니다.
그렇다고 OpenCV 방식이 낡아서 필요 없다는 뜻은 아닙니다.
실제 로봇에서는 둘을 함께 사용하는 경우가 많습니다.
OpenCV
+
Deep Learning
+
LiDAR
+
ROS 2
각 기술의 장점을 조합하는 것이 중요합니다.
39. 학습과 추론을 구분해야 한다
1) Training
Dataset
 ↓
GPU
 ↓
수천~수백만 번 계산
 ↓
Weight Update
 ↓
Model
오랜 시간이 걸립니다.
2) Inference
Camera
 ↓
이미 학습된 Model
 ↓
Prediction
Weight를 새로 학습하지 않습니다.
매우 빠르게 처리해야 합니다.
로봇에서 실시간으로 사용하는 것은 대부분 Inference입니다.
40. 딥러닝 모델은 프로그램이면서 데이터다
전통적인 프로그램에서는 알고리즘이 코드에 있습니다.
if
else
for
딥러닝에서는 중요한 지식이 Weight 안에 저장됩니다.
Architecture
+
Millions of Weights
=
Model
따라서
dl_drive.h5또는
best.pt는 단순한 설정 파일이 아닙니다.
로봇이 학습한 결과가 들어 있는 핵심 자산입니다.
40. 신경회로망에서 LIMO까지
80여 년의 발전을 매우 압축하면 다음과 같습니다.
1943
McCulloch-Pitts
Artificial Neuron
       ↓

1957~1958
Rosenblatt
Perceptron
       ↓

1969
Perceptron의 계산적 한계 분석
       ↓

1980
Neocognitron
       ↓

1986
Backpropagation
       ↓

1989~1998
CNN / LeCun 계열
       ↓

2006
Deep Network 연구 부활
       ↓

2009
ImageNet
       ↓

2012
AlexNet + GPU
       ↓

2015
YOLO
       ↓

현대
TensorFlow
PyTorch
YOLO11
       ↓

ROS 2
       ↓

LIMO Autonomous Robot
최신 딥러닝 기술도 갑자기 등장한 것이 아닙니다.
Artificial Neuron → Learning → Multilayer Network → Backpropagation → CNN → GPU → Big Data → Modern Object Detection