31) 볼륨 증폭 예제
경고 메시지를 크게 출력하려면 다음과 같이 실행합니다.
python3 say.py 경고합니다 장애물이 감지되었습니다 --volume-gain-db 4.0조용하게 출력하려면 다음과 같이 실행합니다.
python3 say.py 시스템 대기 상태입니다 --volume-gain-db -3.0지나치게 큰 값을 사용하면 음질이 저하되거나 왜곡될 수 있으므로 실제 스피커 환경에서 조정해야 합니다.
32) 언어와 음성 모델 변경 예제
영어 음성을 사용하려면 다음처럼 언어 코드와 음성 이름을 함께 변경합니다.
python3 say.py System startup complete --language-code en-US \
    --voice-name en-US-Standard-A
일본어 음성을 사용하려면 다음과 같이 실행할 수 있습니다.
python3 say.py システムを開始します --language-code ja-JP \
    --voice-name ja-JP-Standard-A
음성 이름은 실제 Google Cloud에서 지원하는 값인지 확인해야 합니다.
33) 모든 옵션을 함께 사용하는 예제
python3 say.py 드론 배송 임무를 시작합니다 \
    --language-code ko-KR \
    --voice-name ko-KR-Standard-A \
    --speaking-rate 0.95 \
    --pitch -1.0 \
    --volume-gain-db 2.0 \
    --audio-device plughw:2,0
내부적으로 다음과 비슷한 객체가 생성됩니다.
engine = GoogleTtsEngine(
    language_code="ko-KR",
    voice_name="ko-KR-Standard-A",
    speaking_rate=0.95,
    pitch=-1.0,
    volume_gain_db=2.0,
    audio_device="plughw:2,0",
)
음성으로 출력되는 문자열은 다음과 같습니다.
드론 배송 임무를 시작합니다34) 긴 문장 입력 예제
쉘에서 긴 문장을 입력할 때는 따옴표를 사용하는 것이 안전합니다.
python3 say.py "현재 위치에 도착했습니다. 잠시 후 착륙을 시작합니다."따옴표 없이 입력해도 현재 코드에서는 정상 동작합니다.
python3 say.py 현재 위치에 도착했습니다 잠시 후 착륙을 시작합니다다만 쉘에서 특별한 의미를 갖는 문자가 포함되면 따옴표가 필요합니다.
예를 들어 다음 기호가 포함된 경우 주의해야 합니다.
&|><;$*- 괄호
안전한 방식은 전체 문장을 큰따옴표로 묶는 것입니다.
python3 say.py "배터리 잔량은 30%입니다. 충전이 필요합니다."10. ROS 2 토픽 구독 노드 작성
google_tts_ros2/tts_node.py 파일을 작성합니다.
import queue
import threading
from typing import Optional

import rclpy
from google.api_core.exceptions import (
    GoogleAPICallError,
    RetryError,
)
from rclpy.node import Node
from std_msgs.msg import String

from google_tts_ros2.tts_engine import GoogleTtsEngine


class GoogleTtsNode(Node):
    def __init__(self) -> None:
        super().__init__("google_tts_node")

        self.declare_parameter(
            "topic_name",
            "/tts",
        )
        self.declare_parameter(
            "language_code",
            "ko-KR",
        )
        self.declare_parameter(
            "voice_name",
            "ko-KR-Standard-A",
        )
        self.declare_parameter(
            "speaking_rate",
            1.0,
        )
        self.declare_parameter(
            "pitch",
            0.0,
        )
        self.declare_parameter(
            "volume_gain_db",
            0.0,
        )
        self.declare_parameter(
            "audio_device",
            "default",
        )
        self.declare_parameter(
            "speech_queue_size",
            10,
        )
        self.declare_parameter(
            "startup_text",
            "",
        )

        topic_name = str(
            self.get_parameter("topic_name").value
        )

        queue_size = max(
            1,
            int(
                self.get_parameter(
                    "speech_queue_size"
                ).value
            ),
        )

        self._engine = GoogleTtsEngine(
            language_code=str(
                self.get_parameter(
                    "language_code"
                ).value
            ),
            voice_name=str(
                self.get_parameter(
                    "voice_name"
                ).value
            ),
            speaking_rate=float(
                self.get_parameter(
                    "speaking_rate"
                ).value
            ),
            pitch=float(
                self.get_parameter(
                    "pitch"
                ).value
            ),
            volume_gain_db=float(
                self.get_parameter(
                    "volume_gain_db"
                ).value
            ),
            audio_device=str(
                self.get_parameter(
                    "audio_device"
                ).value
            ),
        )

        self._speech_queue: queue.Queue[
            Optional[str]
        ] = queue.Queue(
            maxsize=queue_size
        )

        self._stop_event = threading.Event()

        self._worker = threading.Thread(
            target=self._worker_loop,
            name="google_tts_worker",
            daemon=True,
        )

        self._worker.start()

        self._subscription = self.create_subscription(
            String,
            topic_name,
            self._topic_callback,
            10,
        )

        self.get_logger().info(
            "Google Cloud TTS 준비 완료: "
            f"topic={topic_name}"
        )

        startup_text = str(
            self.get_parameter(
                "startup_text"
            ).value
        ).strip()

        if startup_text:
            self._enqueue(startup_text)

    def _topic_callback(
        self,
        message: String,
    ) -> None:
        text = message.data.strip()

        if not text:
            self.get_logger().warning(
                "빈 문자열을 수신하여 무시했습니다."
            )
            return

        self._enqueue(text)

    def _enqueue(
        self,
        text: str,
    ) -> None:
        try:
            self._speech_queue.put_nowait(text)

            self.get_logger().info(
                f"TTS 대기열 추가: {text}"
            )

        except queue.Full:
            self.get_logger().warning(
                "TTS 대기열이 가득 차서 "
                "새 문자열을 버렸습니다."
            )

    def _worker_loop(self) -> None:
        while not self._stop_event.is_set():
            try:
                text = self._speech_queue.get(
                    timeout=0.2
                )

            except queue.Empty:
                continue

            if text is None:
                self._speech_queue.task_done()
                break

            try:
                self.get_logger().info(
                    "음성 합성 및 재생 시작: "
                    f"{text}"
                )

                self._engine.speak(text)

            except (
                GoogleAPICallError,
                RetryError,
            ) as error:
                self.get_logger().error(
                    "Google Cloud TTS API 오류: "
                    f"{error}"
                )

            except FileNotFoundError:
                self.get_logger().error(
                    "aplay를 찾을 수 없습니다. "
                    "alsa-utils를 설치하세요."
                )

            except Exception as error:
                self.get_logger().error(
                    f"TTS 처리 실패: {error}"
                )

            finally:
                self._speech_queue.task_done()

    def destroy_node(self) -> bool:
        self._stop_event.set()

        try:
            self._speech_queue.put_nowait(None)

        except queue.Full:
            pass

        if self._worker.is_alive():
            self._worker.join(timeout=1.0)

        return super().destroy_node()


def main(args=None) -> None:
    rclpy.init(args=args)

    node = None

    try:
        node = GoogleTtsNode()
        rclpy.spin(node)

    except KeyboardInterrupt:
        pass

    finally:
        if node is not None:
            node.destroy_node()

        if rclpy.ok():
            rclpy.shutdown()


if __name__ == "__main__":
    main()
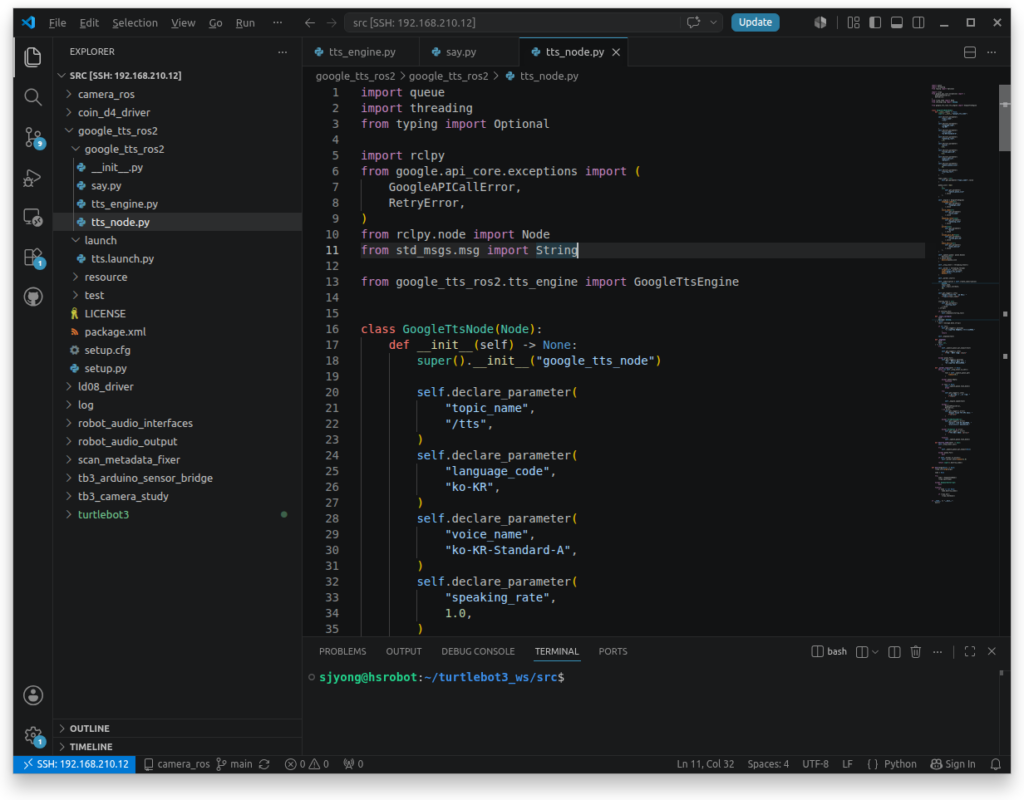
1) 필요한 Python 모듈
소스 상단에서는 다음 모듈을 가져옵니다.
import queue
import threading
from typing import Optional

import rclpy
from google.api_core.exceptions import (
    GoogleAPICallError,
    RetryError,
)
from rclpy.node import Node
from std_msgs.msg import String

from google_tts_ros2.tts_engine import GoogleTtsEngine
각 모듈의 역할은 다음과 같습니다.
queue 모듈
import queuequeue 모듈은 여러 스레드 사이에서 데이터를 안전하게 전달하기 위해 사용합니다.
이 노드에서는 ROS 2 토픽 콜백에서 수신한 문자열을 음성 출력 작업 스레드로 전달하는 용도로 사용합니다.
threading 모듈
import threadingGoogle Cloud TTS 음성 합성과 오디오 재생은 시간이 걸리는 작업입니다.
이 작업을 ROS 2 토픽 콜백 안에서 직접 수행하면 음성 재생이 끝날 때까지 콜백 함수가 반환되지 않습니다.
그 결과 다음 메시지 처리가 지연될 수 있습니다.
이를 방지하기 위해 별도의 스레드에서 음성 합성과 재생을 수행합니다.
Optional 타입
from typing import Optional음성 대기열에는 일반 문자열과 종료 신호인 None이 들어갈 수 있습니다.
따라서 대기열의 타입을 다음과 같이 선언합니다.
queue.Queue[Optional[str]]이는 대기열에 str 또는 None이 저장될 수 있다는 의미입니다.
rclpy
import rclpy
from rclpy.node import Noderclpy는 ROS 2 Python 클라이언트 라이브러리입니다.
Node 클래스를 상속해 사용자 정의 ROS 2 노드를 만들고, rclpy.spin()을 통해 콜백을 처리합니다.
Google Cloud 예외 클래스
from google.api_core.exceptions import (
    GoogleAPICallError,
    RetryError,
)
Google Cloud TTS API 호출 중 발생할 수 있는 오류를 구분해 처리하기 위해 사용합니다.
GoogleAPICallError는 Google API 호출 과정에서 발생한 일반적인 오류를 나타냅니다.
RetryError는 Google API 클라이언트가 요청을 재시도했지만 최종적으로 성공하지 못했을 때 발생합니다.
std_msgs 메시지
from std_msgs.msg import String음성으로 변환할 문자열을 ROS 2 토픽으로 수신하기 위해 std_msgs/msg/String 메시지 타입을 사용합니다.
GoogleTtsEngine
from google_tts_ros2.tts_engine import GoogleTtsEngineGoogleTtsEngine은 실제 Google Cloud TTS API 호출과 오디오 재생을 담당하는 사용자 정의 클래스입니다.
현재 노드는 ROS 2 통신과 작업 관리에 집중하고, 실제 TTS 처리는 GoogleTtsEngine에 위임하는 구조입니다.
이러한 구조는 역할을 분리하기 때문에 유지보수에 유리합니다.
2) GoogleTtsNode 클래스
class GoogleTtsNode(Node):GoogleTtsNode는 ROS 2의 Node 클래스를 상속합니다.
이 클래스는 다음 기능을 담당합니다.
- ROS 2 파라미터 관리
- 문자열 토픽 구독
- 음성 출력 요청 대기열 관리
- TTS 작업 스레드 관리
- 예외 처리
- 노드 종료 처리
3) 노드 초기화
def __init__(self) -> None:
    super().__init__("google_tts_node")
부모 클래스인 Node의 생성자를 호출하면서 노드 이름을 google_tts_node로 지정합니다.
4) topic_name 파라미터
self.declare_parameter(
    "topic_name",
    "/tts",
)
음성 출력 문자열을 수신할 ROS 2 토픽 이름입니다.
기본값은 다음과 같습니다.
/tts따라서 기본 설정에서는 다음 명령으로 음성 출력을 요청할 수 있습니다.
ros2 topic pub --once /tts std_msgs/msg/String "{data: '안녕하세요. 로봇 시스템이 시작되었습니다.'}"5) language_code 파라미터
self.declare_parameter(
    "language_code",
    "ko-KR",
)
Google Cloud TTS에서 사용할 언어 코드를 지정합니다.
기본값은 한국어를 의미하는 ko-KR입니다.
영어 음성을 사용할 경우 다음과 같은 값을 사용할 수 있습니다.
en-US일본어 음성은 다음과 같이 지정할 수 있습니다.
ja-JP언어 코드와 음성 이름은 서로 호환되어야 합니다.
예를 들어 언어 코드는 ko-KR인데 음성 이름을 영어 음성으로 지정하면 API 오류가 발생할 수 있습니다.
6) voice_name 파라미터
self.declare_parameter(
    "voice_name",
    "ko-KR-Standard-A",
)
Google Cloud TTS에서 사용할 음성 모델의 이름입니다.
기본값은 다음과 같습니다.
ko-KR-Standard-AGoogle Cloud TTS는 언어에 따라 여러 음성을 제공합니다.
음성 모델에 따라 성별, 음색, 자연스러움, 비용 등이 달라질 수 있습니다.
사용 가능한 음성은 Google Cloud TTS의 음성 목록 또는 API를 통해 확인해야 합니다.
7) speaking_rate 파라미터
self.declare_parameter(
    "speaking_rate",
    1.0,
)
음성 재생 속도를 지정합니다.
기본값 1.0은 원래 속도를 의미합니다.
예를 들면 다음과 같습니다.
0.8은 기본보다 느린 속도1.0은 기본 속도1.2는 기본보다 빠른 속도1.5는 빠른 안내 방송에 적합한 속도
속도를 지나치게 높이면 발음이 부자연스러워질 수 있습니다.
로봇 상태 안내에서는 보통 0.9에서 1.2 정도가 적절합니다.
8) pitch 파라미터
self.declare_parameter(
    "pitch",
    0.0,
)
합성 음성의 음높이를 조정합니다.
기본값 0.0은 원래 음높이를 사용한다는 의미입니다.
양수 값은 음높이를 높이고 음수 값은 음높이를 낮춥니다.
경고 안내에는 낮고 안정적인 음높이를 사용하고, 친근한 서비스 로봇에는 조금 높은 음높이를 적용할 수 있습니다.
9) volume_gain_db 파라미터
self.declare_parameter(
    "volume_gain_db",
    0.0,
)
합성된 음성의 볼륨 증폭 값을 데시벨 단위로 설정합니다.
기본값 0.0은 추가 증폭을 하지 않는다는 의미입니다.
양수 값을 사용하면 볼륨이 커지고 음수 값을 사용하면 볼륨이 작아집니다.
과도한 증폭은 오디오 왜곡이나 클리핑을 발생시킬 수 있으므로 주의해야 합니다.
10) audio_device 파라미터
self.declare_parameter(
    "audio_device",
    "default",
)
음성을 출력할 오디오 장치를 지정합니다.
기본값은 default입니다.
Linux에서 오디오 장치 목록은 다음 명령으로 확인할 수 있습니다.
aplay -LUSB 스피커나 특정 ALSA 장치를 사용할 경우 audio_device 값을 해당 장치 이름으로 변경할 수 있습니다.
11) speech_queue_size 파라미터
self.declare_parameter(
    "speech_queue_size",
    10,
)
음성 출력 대기열에 저장할 수 있는 최대 문자열 개수입니다.
기본값은 10입니다.
예를 들어 음성 재생 중 새로운 문자열 메시지가 여러 개 들어오면 즉시 재생하지 않고 대기열에 저장합니다.
대기열이 가득 찬 상태에서 새 메시지가 들어오면 새 메시지는 버려집니다.
이 제한은 메모리 사용량이 계속 증가하는 것을 방지합니다.
12) startup_text 파라미터
self.declare_parameter(
    "startup_text",
    "",
)
노드가 시작될 때 자동으로 출력할 음성입니다.
기본값은 빈 문자열이므로 아무 음성도 출력하지 않습니다.
다음과 같이 설정하면 노드 시작 시 안내 음성이 재생됩니다.
startup_text: "음성 안내 시스템이 시작되었습니다."13) 토픽 이름 읽기
topic_name = str(
    self.get_parameter("topic_name").value
)
앞에서 선언한 topic_name 파라미터의 현재 값을 가져옵니다.
get_parameter()는 ROS 2 파라미터 객체를 반환하며, 실제 값은 .value 속성으로 읽습니다.
str()을 사용해 값을 명시적으로 문자열로 변환합니다.
14) 대기열 크기 검증
queue_size = max(
    1,
    int(
        self.get_parameter(
            "speech_queue_size"
        ).value
    ),
)
speech_queue_size 파라미터를 정수로 변환하고 최소값을 1로 제한합니다.
사용자가 실수로 다음과 같은 값을 입력하더라도 대기열 크기는 1이 됩니다.
0또는
-5queue.Queue의 maxsize에 잘못된 값이 들어가는 것을 방지하기 위한 방어적 코드입니다.
15) GoogleTtsEngine 객체 생성
self._engine = GoogleTtsEngine(
    language_code=str(
        self.get_parameter(
            "language_code"
        ).value
    ),
    voice_name=str(
        self.get_parameter(
            "voice_name"
        ).value
    ),
    speaking_rate=float(
        self.get_parameter(
            "speaking_rate"
        ).value
    ),
    pitch=float(
        self.get_parameter(
            "pitch"
        ).value
    ),
    volume_gain_db=float(
        self.get_parameter(
            "volume_gain_db"
        ).value
    ),
    audio_device=str(
        self.get_parameter(
            "audio_device"
        ).value
    ),
)
ROS 2 파라미터 값을 읽어 GoogleTtsEngine 객체에 전달합니다.
각 값은 예상되는 타입으로 명시적으로 변환합니다.
language_code는 문자열voice_name은 문자열speaking_rate는 실수pitch는 실수volume_gain_db는 실수audio_device는 문자열
GoogleTtsEngine 내부에서는 일반적으로 다음 작업을 수행하게 됩니다.
- Google Cloud TTS 클라이언트 생성
- 입력 문자열 설정
- 언어와 음성 모델 설정
- 음성 속도와 음높이 설정
- API를 통한 음성 합성 요청
- 합성된 오디오 데이터 저장 또는 스트리밍
aplay등을 이용한 음성 재생
현재 노드에서는 이러한 세부 구현을 알 필요 없이 다음 메서드만 호출합니다.
self._engine.speak(text)16) 음성 대기열 생성
self._speech_queue: queue.Queue[
    Optional[str]
] = queue.Queue(
    maxsize=queue_size
)
음성 출력 요청을 저장하는 대기열입니다.
대기열에는 다음 두 종류의 데이터가 들어갑니다.
- 음성으로 변환할 문자열
- 작업 스레드 종료를 의미하는
None
예를 들면 대기열 상태는 다음과 같을 수 있습니다.
[
    "로봇이 출발합니다.",
    "장애물이 감지되었습니다.",
    "목적지에 도착했습니다."
]
작업 스레드는 첫 번째 문자열부터 순서대로 처리합니다.
queue.Queue는 기본적으로 FIFO 방식입니다.
FIFO는 먼저 들어온 데이터가 먼저 나가는 구조를 의미합니다.
17) 종료 이벤트 생성
self._stop_event = threading.Event()작업 스레드에 종료 요청을 전달하기 위한 이벤트 객체입니다.
초기 상태에서는 이벤트가 설정되지 않습니다.
self._stop_event.is_set()위 호출은 처음에는 False를 반환합니다.
노드가 종료될 때 다음 코드가 실행됩니다.
self._stop_event.set()그 이후에는 is_set()이 True를 반환하므로 작업 스레드의 반복문이 종료됩니다.
18) 작업 스레드 생성
self._worker = threading.Thread(
    target=self._worker_loop,
    name="google_tts_worker",
    daemon=True,
)
음성 합성과 재생을 담당할 별도의 스레드를 생성합니다.
각 인자의 의미는 다음과 같습니다.
target=self._worker_loop작업 스레드가 실행할 함수입니다.name="google_tts_worker"스레드 이름입니다.디버깅이나 로그 분석 시 스레드를 식별하기 쉽습니다.daemon=True데몬 스레드로 설정합니다.메인 프로그램이 완전히 종료될 때 이 스레드가 프로세스 종료를 막지 않도록 합니다.
다만 데몬 스레드라고 해서 종료 처리를 생략해도 된다는 뜻은 아닙니다.
현재 코드는 destroy_node()에서 명시적으로 종료 요청을 보내고 스레드가 끝날 때까지 일정 시간 기다립니다.
19) 작업 스레드 시작
self._worker.start()스레드를 실제로 실행합니다.
이 시점부터 _worker_loop() 메서드가 별도로 동작하며 대기열에 음성 출력 요청이 들어오기를 기다립니다.
20) ROS 2 구독자 생성
self._subscription = self.create_subscription(
    String,
    topic_name,
    self._topic_callback,
    10,
)
문자열 메시지를 수신하기 위한 ROS 2 구독자를 생성합니다.
각 인자의 의미는 다음과 같습니다.
String구독할 메시지 타입입니다.topic_name구독할 토픽 이름입니다.self._topic_callback메시지를 수신했을 때 호출할 함수입니다.10ROS 2 구독자의 QoS 큐 깊이입니다.
여기서 구독자의 QoS 큐와 음성 출력 대기열은 서로 다른 구조입니다.
ROS 2 구독 큐는 아직 콜백에서 처리하지 못한 메시지를 임시 보관합니다.
self._speech_queue는 콜백 처리가 완료된 후 실제 음성 재생 순서를 관리합니다.
21) 노드 준비 완료 로그
self.get_logger().info(
    "Google Cloud TTS 준비 완료: "
    f"topic={topic_name}"
)
노드 초기화가 완료되면 구독 중인 토픽 이름을 로그로 출력합니다.
실행 시 다음과 비슷한 메시지가 표시됩니다.
[INFO] [google_tts_node]: Google Cloud TTS 준비 완료: topic=/tts22) 시작 안내 음성 처리
startup_text = str(
    self.get_parameter(
        "startup_text"
    ).value
).strip()
startup_text 파라미터 값을 읽고 앞뒤 공백을 제거합니다.
이후 문자열이 비어 있지 않으면 대기열에 추가합니다.
if startup_text:
    self._enqueue(startup_text)
중요한 점은 시작 안내 음성도 직접 재생하지 않고 일반 토픽 메시지와 동일하게 대기열에 추가한다는 것입니다.
따라서 음성 재생 처리 흐름이 하나로 통일됩니다.
23) 토픽 콜백 함수
def _topic_callback(
    self,
    message: String,
) -> None:
/tts 토픽으로 std_msgs/msg/String 메시지가 들어오면 호출됩니다.
메시지의 실제 문자열은 message.data에 저장되어 있습니다.
text = message.data.strip()strip()을 사용해 문자열 앞뒤 공백과 줄바꿈 문자를 제거합니다.
예를 들어 다음 문자열을 수신했다고 가정하겠습니다.
" 로봇이 출발합니다. "처리 후에는 다음 문자열이 됩니다.
"로봇이 출발합니다."24) 빈 문자열 검사
if not text:
    self.get_logger().warning(
        "빈 문자열을 수신하여 무시했습니다."
    )
    return
문자열이 비어 있으면 Google Cloud TTS API를 호출하지 않습니다.
빈 문자열을 API에 전달하면 불필요한 요청이 발생하거나 API 오류가 발생할 수 있습니다.
따라서 경고 로그만 출력하고 콜백을 종료합니다.
다음과 같은 메시지는 무시됩니다.
ros2 topic pub --once /tts std_msgs/msg/String "{data: ''}"공백만 포함된 문자열도 strip() 이후 빈 문자열이 되므로 무시됩니다.
25) 대기열에 문자열 추가
self._enqueue(text)유효한 문자열은 _enqueue() 메서드로 전달됩니다.
콜백 함수에서는 음성 합성이나 재생을 직접 수행하지 않습니다.
이 구조 덕분에 콜백 함수는 빠르게 반환됩니다.
26) _enqueue 메서드
def _enqueue(
    self,
    text: str,
) -> None:
음성으로 출력할 문자열을 대기열에 추가하는 메서드입니다.
self._speech_queue.put_nowait(text)put_nowait()는 대기열에 빈 공간이 있으면 즉시 데이터를 추가합니다.
대기열이 가득 찼더라도 기다리지 않고 바로 queue.Full 예외를 발생시킵니다.
이 방식은 ROS 2 콜백이 대기열 공간이 생길 때까지 멈추는 문제를 방지합니다.
27) 대기열 추가 성공 로그
self.get_logger().info(
    f"TTS 대기열 추가: {text}"
)
문자열이 정상적으로 대기열에 추가되면 로그를 출력합니다.
예시는 다음과 같습니다.
[INFO] [google_tts_node]: TTS 대기열 추가: 로봇이 출발합니다.개발 단계에서는 유용하지만, 실제 서비스에서는 로그가 너무 많이 발생할 수 있습니다.
운영 환경에서는 info 대신 debug 레벨을 사용하는 것도 좋은 방법입니다.
28) 대기열이 가득 찬 경우
except queue.Full:
    self.get_logger().warning(
        "TTS 대기열이 가득 차서 "
        "새 문자열을 버렸습니다."
    )
음성 출력 속도보다 메시지 입력 속도가 빠르면 대기열이 가득 찰 수 있습니다.
예를 들어 대기열 크기가 10이고 10개의 문장이 재생을 기다리는 상태라면 11번째 문장은 버려집니다.
이 정책은 오래된 메시지를 유지하고 새로운 메시지를 버리는 방식입니다.
상태 안내 시스템에서는 이 정책이 항상 최선은 아닐 수 있습니다.
긴급 경고 메시지가 들어왔는데 대기열이 가득 차 있다면 긴급 메시지가 버려질 수 있기 때문입니다.
실제 로봇 시스템에서는 메시지 중요도에 따라 다음 정책을 고려할 수 있습니다.
- 가장 오래된 메시지를 제거하고 새 메시지 추가
- 긴급 메시지 전용 대기열 사용
- 우선순위 대기열 사용
- 현재 음성 재생 중단 후 긴급 음성 재생
- 같은 내용의 중복 메시지 제거
29) 작업 스레드 반복문
def _worker_loop(self) -> None:
    while not self._stop_event.is_set():
작업 스레드는 종료 이벤트가 설정되지 않은 동안 계속 실행됩니다.
이 스레드는 음성 출력 대기열을 감시하고 문자열이 들어오면 하나씩 처리합니다.
30) 대기열 데이터 가져오기
text = self._speech_queue.get(
    timeout=0.2
)
대기열에서 데이터를 하나 가져옵니다.
timeout=0.2는 최대 0.2초 동안 데이터가 들어오기를 기다린다는 의미입니다.
대기열에 데이터가 없으면 0.2초 후 queue.Empty 예외가 발생합니다.
무한정 대기하지 않고 타임아웃을 사용하는 이유는 종료 이벤트를 주기적으로 확인하기 위해서입니다.
만약 다음처럼 타임아웃 없이 호출한다면 스레드는 데이터가 들어올 때까지 계속 멈춰 있을 수 있습니다.
self._speech_queue.get()현재 구조에서는 최대 0.2초마다 종료 여부를 확인할 수 있습니다.
31) 빈 대기열 처리
except queue.Empty:
    continue
0.2초 동안 데이터가 들어오지 않으면 반복문의 처음으로 돌아갑니다.
이후 _stop_event 상태를 다시 확인하고 종료 요청이 없으면 다시 대기합니다.
32) 종료 신호 처리
if text is None:
    self._speech_queue.task_done()
    break
대기열에서 가져온 값이 None이면 작업 스레드 종료 신호로 판단합니다.
None은 실제 음성 문자열로 사용되지 않으므로 종료용 센티널 값으로 사용할 수 있습니다.
센티널은 데이터 흐름에 특수한 값을 넣어 종료나 상태 변경을 전달하는 방식입니다.
task_done()을 호출한 후 반복문을 종료합니다.
33) 음성 합성 및 재생 시작 로그
self.get_logger().info(
    "음성 합성 및 재생 시작: "
    f"{text}"
)
실제 TTS 처리를 시작하기 전에 현재 처리 중인 문자열을 로그로 출력합니다.
이를 통해 대기열에 추가된 시점과 실제 재생이 시작된 시점을 구분할 수 있습니다.
34) 실제 음성 출력
self._engine.speak(text)현재 노드의 핵심 실행 코드입니다.
GoogleTtsEngine의 speak() 메서드가 다음 작업을 수행한다고 볼 수 있습니다.
- 문자열을 Google Cloud TTS API에 전달
- 음성 데이터 생성
- 생성된 오디오 데이터 수신
- 임시 파일 또는 메모리에 저장
- 지정된 ALSA 오디오 장치로 재생
- 재생 완료 후 반환
speak() 메서드가 음성 재생이 끝날 때까지 반환하지 않는 동기 방식이어도 문제가 없습니다.
별도의 작업 스레드에서 실행되기 때문에 ROS 2 토픽 콜백 처리는 계속 진행될 수 있습니다.
35) Google Cloud API 오류 처리
except (
    GoogleAPICallError,
    RetryError,
) as error:
    self.get_logger().error(
        "Google Cloud TTS API 오류: "
        f"{error}"
    )
Google Cloud TTS 요청 중 발생한 오류를 처리합니다.
대표적인 원인은 다음과 같습니다.
- 인터넷 연결 실패
- Google Cloud 인증 실패
- 서비스 계정 키 오류
- TTS API 비활성화
- 잘못된 음성 이름
- 잘못된 언어 코드
- API 사용량 제한 초과
- 결제 계정 문제
- 요청 타임아웃
- Google Cloud 서비스 일시 장애
예외를 처리하지 않으면 작업 스레드가 종료될 수 있습니다.
현재 코드는 오류 로그를 출력한 후 다음 대기열 항목을 계속 처리합니다.
36) aplay 실행 파일 오류 처리
except FileNotFoundError:
    self.get_logger().error(
        "aplay를 찾을 수 없습니다. "
        "alsa-utils를 설치하세요."
)GoogleTtsEngine이 Linux의 aplay 명령으로 음성을 재생하는 경우 aplay가 설치되어 있지 않으면 FileNotFoundError가 발생할 수 있습니다.
Ubuntu에서는 다음 명령으로 설치할 수 있습니다.
sudo apt update
sudo apt install alsa-utils
설치 후 다음 명령으로 정상 동작을 확인할 수 있습니다.
aplay --version37) 기타 예외 처리
except Exception as error:
    self.get_logger().error(
        f"TTS 처리 실패: {error}"
    )
예상하지 못한 모든 예외를 마지막에 처리합니다.
발생 가능한 오류는 다음과 같습니다.
- 임시 오디오 파일 생성 실패
- 파일 접근 권한 오류
- 오디오 장치 열기 실패
- 잘못된 파라미터 값
- 내부 라이브러리 오류
- 오디오 재생 프로세스 오류
광범위한 Exception 처리는 작업 스레드가 예상하지 못한 오류로 완전히 종료되는 것을 방지합니다.
다만 실제 운영 환경에서는 예외 타입과 스택 정보를 함께 기록하도록 개선하는 것이 좋습니다.
38) task_done 호출
finally:
    self._speech_queue.task_done()
음성 출력이 성공하든 실패하든 대기열 작업이 끝났음을 알립니다.
task_done()은 queue.Queue 내부의 미완료 작업 개수를 감소시킵니다.
이 값은 다른 코드에서 다음 메서드를 사용할 때 필요합니다.
self._speech_queue.join()현재 소스에서는 join()을 사용하지 않지만, 대기열의 올바른 사용 규칙을 지키기 위해 task_done()을 호출하고 있습니다.
finally 블록에 있기 때문에 예외가 발생해도 반드시 실행됩니다.
39) destroy_node 메서드 재정의
def destroy_node(self) -> bool:ROS 2 노드가 종료될 때 작업 스레드와 대기열을 안전하게 정리하기 위해 부모 클래스의 destroy_node() 메서드를 재정의합니다.
단순히 ROS 2 노드만 삭제하면 작업 스레드가 실행 중인 상태로 남거나 음성 재생 프로세스가 비정상 종료될 수 있습니다.
a. 종료 이벤트 설정
self._stop_event.set()작업 스레드에 종료 요청을 전달합니다.
이후 작업 스레드의 반복 조건은 거짓이 됩니다.
while not self._stop_event.is_set():b. 대기열에 종료 신호 추가
try:
    self._speech_queue.put_nowait(None)

except queue.Full:
    pass
작업 스레드가 queue.get()에서 대기 중일 수 있으므로 대기열에 None을 추가해 즉시 깨우려고 시도합니다.
대기열에 공간이 있으면 None이 들어가고 작업 스레드는 이를 종료 신호로 처리합니다.
대기열이 가득 차 있다면 queue.Full 예외가 발생합니다.
이 경우 이미 _stop_event가 설정되어 있으므로 별도의 처리를 하지 않습니다.
다만 현재 구현에는 한 가지 주의점이 있습니다.
작업 스레드가 이미 대기열에서 문자열을 꺼내 음성을 재생 중이라면 _engine.speak()가 반환될 때까지 즉시 종료되지 않을 수 있습니다.
40) 작업 스레드 종료 대기
if self._worker.is_alive():
    self._worker.join(timeout=1.0)
작업 스레드가 아직 실행 중이면 최대 1초 동안 종료를 기다립니다.
join()을 사용하지 않으면 메인 스레드가 먼저 종료되면서 작업 스레드가 정리되지 않을 수 있습니다.
다만 음성 재생이 1초 이상 남아 있으면 작업 스레드는 완전히 종료되지 않은 상태에서 join() 타임아웃이 끝날 수 있습니다.
현재 작업 스레드는 데몬 스레드이므로 최종적으로 프로세스가 종료될 때 함께 종료됩니다.
더 엄격한 종료 처리가 필요하다면 GoogleTtsEngine에 현재 오디오 재생을 중단하는 기능을 추가하는 것이 좋습니다.