9. 문자열을 즉시 재생하는 실행 파일 작성
google_tts_ros2/say.py 파일을 작성합니다.
import argparse
import sys

from google_tts_ros2.tts_engine import GoogleTtsEngine


def main() -> int:
    parser = argparse.ArgumentParser(
        description=(
            "Google Cloud Text-to-Speech로 "
            "문자열을 즉시 재생합니다."
        )
    )

    parser.add_argument(
        "text",
        nargs="+",
        help="음성으로 출력할 문자열",
    )

    parser.add_argument(
        "--language-code",
        default="ko-KR",
    )

    parser.add_argument(
        "--voice-name",
        default="ko-KR-Standard-A",
    )

    parser.add_argument(
        "--speaking-rate",
        type=float,
        default=1.0,
    )

    parser.add_argument(
        "--pitch",
        type=float,
        default=0.0,
    )

    parser.add_argument(
        "--volume-gain-db",
        type=float,
        default=0.0,
    )

    parser.add_argument(
        "--audio-device",
        default="default",
    )

    args = parser.parse_args()

    engine = GoogleTtsEngine(
        language_code=args.language_code,
        voice_name=args.voice_name,
        speaking_rate=args.speaking_rate,
        pitch=args.pitch,
        volume_gain_db=args.volume_gain_db,
        audio_device=args.audio_device,
    )

    try:
        engine.speak(" ".join(args.text))

    except Exception as error:
        print(
            f"TTS 실행 실패: {error}",
            file=sys.stderr,
        )
        return 1

    return 0


if __name__ == "__main__":
    raise SystemExit(main())
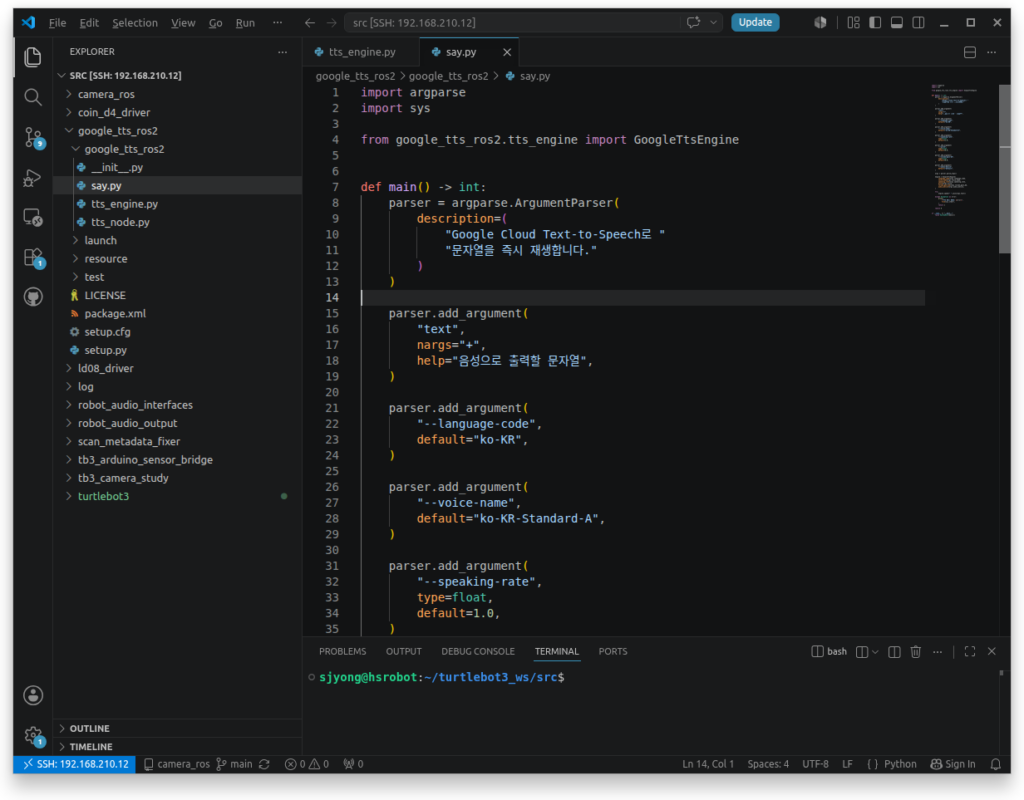
이 실행 파일은 ROS 2 토픽을 사용하지 않고 명령행에서 전달한 문자열을 바로 음성으로 출력합니다.
1) argparse 모듈 가져오기
import argparseargparse는 Python 표준 라이브러리에 포함된 명령줄 인수 분석 모듈입니다.
별도의 패키지를 설치하지 않아도 사용할 수 있습니다.
argparse를 사용하면 다음 기능을 쉽게 구현할 수 있습니다.
- 필수 인수 정의
- 선택 옵션 정의
- 기본값 설정
- 문자열을 숫자로 변환
- 도움말 자동 생성
- 잘못된 인수 검사
- 사용법 자동 출력
예를 들어 프로그램에 --help 옵션을 전달하면 argparse가 자동으로 도움말을 출력합니다.
python3 say.py --help출력 형태는 다음과 비슷합니다.
usage: say.py [-h]
                  [--language-code LANGUAGE_CODE]
                  [--voice-name VOICE_NAME]
                  [--speaking-rate SPEAKING_RATE]
                  [--pitch PITCH]
                  [--volume-gain-db VOLUME_GAIN_DB]
                  [--audio-device AUDIO_DEVICE]
                  text [text ...]

Google Cloud Text-to-Speech로 문자열을 즉시 재생합니다.
직접 도움말 처리 코드를 작성하지 않아도 된다는 것이 argparse의 큰 장점입니다.
2) sys 모듈 가져오기
import syssys 역시 Python 표준 라이브러리입니다.
이번 코드에서는 다음 목적으로 사용합니다.
- 오류 메시지를 표준 오류 출력으로 전송
- 프로그램 종료 상태 관리
실제 사용 부분은 다음과 같습니다.
file=sys.stderrsys.stderr는 표준 오류 출력 스트림입니다.
일반 출력과 오류 출력을 분리하면 쉘 스크립트나 로그 수집 시스템에서 성공 메시지와 실패 메시지를 구분하기 쉬워집니다.
3) GoogleTtsEngine 클래스 가져오기
from google_tts_ros2.tts_engine import GoogleTtsEngine이 코드는 google_tts_ros2 Python 패키지 안에 있는 tts_engine.py 모듈에서 GoogleTtsEngine 클래스를 가져옵니다.
패키지 구조는 일반적으로 다음과 같이 구성할 수 있습니다.
google_tts_ros2/
├── google_tts_ros2/
│   ├── __init__.py
│   ├── tts_engine.py
│   └── say.py
├── package.xml
├── resource/
├── setup.cfg
└── setup.py
각 파일의 역할은 다음과 같습니다.
tts_engine.py: Google Cloud TTS 음성 합성과 재생 기능say.py: 명령줄 인수를 받아 TTS 엔진 실행setup.py: Python 패키지와 실행 엔트리 포인트 설정package.xml: ROS 2 패키지 정보와 의존성 정의setup.cfg: ROS 2 실행 파일 설치 위치 설정
GoogleTtsEngine은 실제 음성 합성과 재생을 담당하고, 현재 소스는 사용자 입력과 실행 흐름만 담당합니다.
이처럼 기능을 분리하면 유지보수가 쉬워집니다.
4) main 함수 정의
def main() -> int:main() 함수는 프로그램의 핵심 실행 흐름을 담당합니다.
반환 자료형은 int로 지정되어 있습니다.
-> int반환값은 프로그램의 종료 코드로 사용됩니다.
일반적인 종료 코드 의미는 다음과 같습니다.
0: 정상 종료1: 일반적인 실행 오류2: 명령줄 인수 오류- 그 외 값: 프로그램에서 정의한 특정 오류
현재 코드에서는 성공 시 0, TTS 실행 실패 시 1을 반환합니다.
5) ArgumentParser 객체 생성
parser = argparse.ArgumentParser(
    description=(
        "Google Cloud Text-to-Speech로 "
        "문자열을 즉시 재생합니다."
    )
)ArgumentParser는 명령줄 인수를 관리하는 핵심 객체입니다.
이 객체를 이용해 프로그램이 받을 인수와 옵션을 등록합니다.
description은 프로그램의 목적을 설명하는 문자열입니다.
사용자가 다음 명령을 실행하면 설명이 표시됩니다.
python3 say.py --help문자열을 괄호 안에서 두 줄로 나눠 작성했지만 Python에서는 자동으로 하나의 문자열로 연결됩니다.
description=(
    "Google Cloud Text-to-Speech로 "
    "문자열을 즉시 재생합니다."
)
실제 문자열은 다음과 같습니다.
Google Cloud Text-to-Speech로 문자열을 즉시 재생합니다.이 방식은 한 줄이 지나치게 길어지는 것을 방지하면서도 문자열 연결 연산자를 사용하지 않아도 된다는 장점이 있습니다.
6) 필수 위치 인수 text 등록
parser.add_argument(
    "text",
    nargs="+",
    help="음성으로 출력할 문자열",
)text는 음성으로 출력할 문장을 받는 필수 위치 인수입니다.
위치 인수는 옵션 이름 없이 입력합니다.
python3 say.py 안녕하세요여기서 안녕하세요가 text 인수에 저장됩니다.
여러 단어를 입력할 수도 있습니다.
python3 say.py 로봇 시스템을 시작합니다이 경우 각 단어는 리스트의 개별 항목으로 저장됩니다.
args.text결과는 다음과 비슷합니다.
[
    "로봇",
    "시스템을",
    "시작합니다",
]
7) nargs 옵션의 의미
nargs="+"nargs는 해당 인수가 몇 개의 값을 받을 수 있는지 지정합니다.
"+"는 하나 이상의 값을 반드시 받아야 한다는 의미입니다.
따라서 다음 명령은 정상입니다.
python3 say.py 안녕하세요다음 명령도 정상입니다.
python3 say.py 시스템 점검을 시작합니다하지만 문자열 없이 실행하면 오류가 발생합니다.
python3 say.py이 경우 argparse가 자동으로 오류 메시지를 출력합니다.
error: the following arguments are required: text그리고 일반적으로 종료 코드 2로 프로그램을 종료합니다.
nargs="+"를 사용한 이유는 쉘에서 공백으로 분리된 여러 단어를 모두 입력받기 위해서입니다.
8) text 도움말 설정
help="음성으로 출력할 문자열"help는 --help 실행 시 해당 인수에 표시되는 설명입니다.
출력 예시는 다음과 같습니다.
positional arguments:
  text    음성으로 출력할 문자열
명령줄 프로그램은 사용자 인터페이스가 단순하기 때문에 도움말 문구가 중요합니다.
9) language-code 옵션 등록
parser.add_argument(
    "--language-code",
    default="ko-KR",
)--language-code는 음성 합성 언어를 지정하는 선택 옵션입니다.
기본값은 다음과 같습니다.
ko-KRko-KR은 대한민국 한국어를 의미합니다.
옵션을 생략하면 기본값이 사용됩니다.
python3 say.py 안녕하세요위 명령은 내부적으로 다음 설정을 사용합니다.
language_code="ko-KR"다른 언어를 사용하려면 다음과 같이 입력할 수 있습니다.
python3 say.py Hello world \
    --language-code en-US
일본어를 사용하려면 다음과 같이 지정할 수 있습니다.
python3 say.py こんにちは \
    --language-code ja-JP
대표적인 언어 코드는 다음과 같습니다.
ko-KR: 한국어en-US: 미국 영어en-GB: 영국 영어ja-JP: 일본어zh-CN: 중국어 간체de-DE: 독일어fr-FR: 프랑스어
언어 코드와 음성 이름은 서로 일치해야 합니다.
예를 들어 language-code를 en-US로 지정하면서 한국어 음성 이름을 그대로 사용하면 API 오류가 발생할 수 있습니다.
10) voice-name 옵션 등록
parser.add_argument(
    "--voice-name",
    default="ko-KR-Standard-A",
)--voice-name은 Google Cloud Text-to-Speech에서 사용할 음성 모델을 지정합니다.
기본값은 다음과 같습니다.
ko-KR-Standard-A사용 예시는 다음과 같습니다.
python3 say.py 안내 방송을 시작합니다 \
    --voice-name ko-KR-Standard-A
다른 음성 모델을 사용하려면 설치된 라이브러리와 Google Cloud에서 지원하는 정확한 음성 이름을 지정해야 합니다.
음성 이름은 다음 요소에 영향을 줍니다.
- 목소리 특성
- 남성 또는 여성 음성
- 자연스러움
- 음색
- 사용 요금
- 지원 기능
언어 코드를 변경하는 경우 음성 이름도 함께 변경하는 것이 안전합니다.
python3 say.py Hello --language-code en-US --voice-name en-US-Standard-A11) speaking-rate 옵션 등록
parser.add_argument(
    "--speaking-rate",
    type=float,
    default=1.0,
)--speaking-rate는 말하기 속도를 지정합니다.
기본값은 1.0입니다.
1.01.0은 기본 속도를 의미합니다.
느리게 읽게 하려면 다음과 같이 지정할 수 있습니다.
python3 say.py 천천히 안내합니다 --speaking-rate 0.8빠르게 읽게 하려면 다음과 같이 지정할 수 있습니다.
python3 say.py 빠르게 안내합니다 --speaking-rate 1.2type=float가 지정되어 있으므로 사용자가 입력한 문자열은 자동으로 실수형으로 변환됩니다.
type=float명령줄에서 입력되는 모든 값은 기본적으로 문자열입니다.
예를 들어 다음 값을 입력하면
--speaking-rate 0.9argparse가 다음처럼 변환합니다.
args.speaking_rate == 0.9잘못된 문자열을 입력하면 자동으로 오류가 발생합니다.
python3 say.py 테스트 --speaking-rate fast출력 예시는 다음과 같습니다.
error: argument --speaking-rate: invalid float value: 'fast'12) pitch 옵션 등록
parser.add_argument(
    "--pitch",
    type=float,
    default=0.0,
)--pitch는 음성의 높낮이를 조절합니다.
기본값은 0.0입니다.
0.0양수 값을 사용하면 음성이 높아지고, 음수 값을 사용하면 음성이 낮아집니다.
낮은 목소리를 사용하려면 다음과 같이 실행합니다.
python3 say.py 시스템 점검을 시작합니다 --pitch -2.0높은 목소리를 사용하려면 다음과 같이 실행합니다.
python3 say.py 알림이 도착했습니다 --pitch 2.0pitch 역시 실수형 값이므로 type=float가 지정되어 있습니다.
13) volume-gain-db 옵션 등록
parser.add_argument(
    "--volume-gain-db",
    type=float,
    default=0.0,
)--volume-gain-db는 음성 합성 단계에서 적용할 볼륨 증폭값을 데시벨 단위로 지정합니다.
기본값은 0.0입니다.
음량을 증가시키려면 다음과 같이 사용합니다.
python3 say.py 경고합니다 --volume-gain-db 3.0음량을 감소시키려면 다음과 같이 사용합니다.
python3 say.py 조용한 안내입니다 --volume-gain-db -3.0이 옵션은 운영체제의 마스터 볼륨을 직접 변경하지 않습니다.
실제 출력 음량은 다음 요소에 함께 영향을 받습니다.
- Google TTS의 볼륨 설정
- ALSA 믹서 볼륨
- PulseAudio 또는 PipeWire 설정
- USB 오디오 장치 출력
- 외부 앰프의 증폭률
- 스피커 자체 볼륨
Linux 시스템의 오디오 볼륨은 다음 명령으로 확인할 수 있습니다.
alsamixer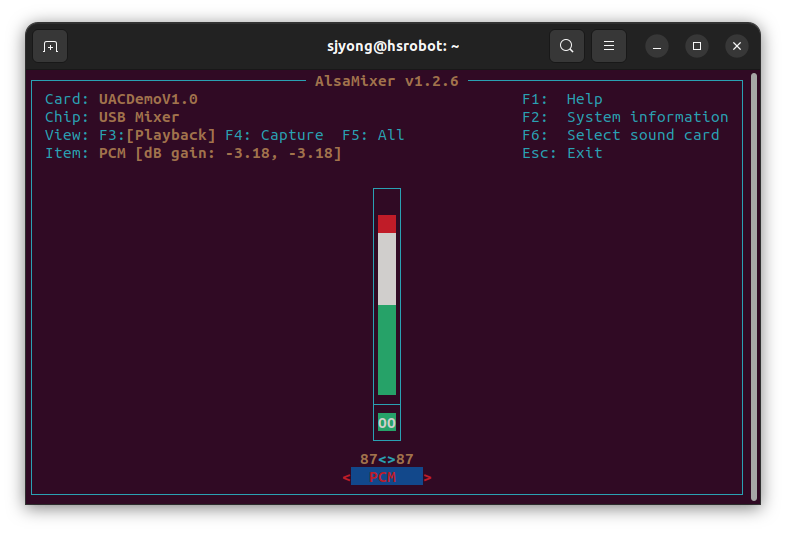
14) audio-device 옵션 등록
parser.add_argument(
    "--audio-device",
    default="default",
)--audio-device는 aplay가 사용할 ALSA 출력 장치를 지정합니다.
기본값은 다음과 같습니다.
default기본 장치를 사용하면 다음과 같이 실행합니다.
python3 say.py 기본 스피커 테스트입니다특정 장치를 사용하려면 다음과 같이 지정합니다.
python3 say.py USB 오디오 출력 테스트입니다 --audio-device plughw:2,0사용 가능한 장치는 다음 명령으로 확인할 수 있습니다.
aplay -l논리적인 ALSA 장치 이름은 다음 명령으로 확인할 수 있습니다.
aplay -LJetson, Raspberry Pi 또는 산업용 Ubuntu 시스템에서는 HDMI, USB 오디오, 내장 오디오 장치가 동시에 존재할 수 있습니다.
이런 환경에서는 장치를 명시적으로 지정하는 것이 안정적입니다.
15) 명령줄 인수 분석
args = parser.parse_args()parse_args()는 사용자가 입력한 명령줄 인수를 분석합니다.
예를 들어 다음 명령을 실행한다고 가정할 수 있습니다.
python3 say.py 로봇 시스템을 시작합니다 --speaking-rate 0.9 \
    --pitch -1.0 --audio-device plughw:2,0
분석 결과는 개념적으로 다음과 같습니다.
args.text = [
    "로봇",
    "시스템을",
    "시작합니다",
]

args.language_code = "ko-KR"
args.voice_name = "ko-KR-Standard-A"
args.speaking_rate = 0.9
args.pitch = -1.0
args.volume_gain_db = 0.0
args.audio_device = "plughw:2,0"
옵션 이름의 하이픈은 Python 속성에서 밑줄로 변경됩니다.
예를 들어 명령줄 옵션은 다음과 같습니다.
--language-codePython에서는 다음처럼 접근합니다.
args.language_code다음 옵션도 같은 방식으로 변환됩니다.
--speaking-rateargs.speaking_rate16) GoogleTtsEngine 객체 생성
engine = GoogleTtsEngine(
    language_code=args.language_code,
    voice_name=args.voice_name,
    speaking_rate=args.speaking_rate,
    pitch=args.pitch,
    volume_gain_db=args.volume_gain_db,
    audio_device=args.audio_device,
)
분석된 명령줄 옵션을 이용해 GoogleTtsEngine 객체를 생성합니다.
각 값은 다음과 같이 전달됩니다.
args.language_code는 음성 언어로 전달됩니다.args.voice_name은 음성 모델 이름으로 전달됩니다.args.speaking_rate는 말하기 속도로 전달됩니다.args.pitch는 음높이로 전달됩니다.args.volume_gain_db는 볼륨 증폭값으로 전달됩니다.args.audio_device는 ALSA 출력 장치로 전달됩니다.
기본 옵션으로 실행하면 내부적으로 다음과 비슷한 객체가 생성됩니다.
engine = GoogleTtsEngine(
    language_code="ko-KR",
    voice_name="ko-KR-Standard-A",
    speaking_rate=1.0,
    pitch=0.0,
    volume_gain_db=0.0,
    audio_device="default",
)
명령줄 옵션과 클래스 생성자 인수 이름이 동일하게 구성되어 있어 코드를 이해하기 쉽습니다.
17) try 문을 이용한 오류 처리 시작
try:
    engine.speak(" ".join(args.text))
TTS 실행 과정에서는 여러 종류의 오류가 발생할 수 있습니다.
예상 가능한 오류는 다음과 같습니다.
- Google Cloud 인증 실패
- 인터넷 연결 실패
- Text-to-Speech API 비활성화
- 서비스 계정 권한 부족
- 잘못된 언어 코드
- 잘못된 음성 이름
- 음성 합성 제한값 초과
aplay설치 누락- ALSA 장치 탐색 실패
- 오디오 장치 사용 중
- 스피커 권한 문제
- 잘못된 오디오 장치 이름
이런 오류가 프로그램 전체의 Python 예외 추적 메시지로 출력되는 대신, 사용자에게 필요한 핵심 오류만 보여주도록 try와 except를 사용합니다.
18) 여러 단어를 하나의 문장으로 결합
" ".join(args.text)args.text는 문자열이 아니라 문자열 리스트입니다.
예를 들어 다음 명령을 실행하면
python3 say.py 로봇 시스템을 시작합니다args.text는 다음과 같습니다.
[
    "로봇",
    "시스템을",
    "시작합니다",
]join()은 리스트의 각 문자열 사이에 공백을 넣어 하나의 문자열로 결합합니다.
" ".join(args.text)결과는 다음과 같습니다.
로봇 시스템을 시작합니다이 결과가 engine.speak()에 전달됩니다.
19) 따옴표로 문장 입력하기
현재 코드는 nargs="+"를 사용하기 때문에 문장을 따옴표 없이 입력해도 됩니다.
python3 say.py 로봇 시스템을 시작합니다따옴표를 사용해 하나의 인수로 전달해도 정상 동작합니다.
python3 say.py "로봇 시스템을 시작합니다"첫 번째 방식에서 args.text는 여러 항목으로 구성됩니다.
[
    "로봇",
    "시스템을",
    "시작합니다",
]
두 번째 방식에서는 한 항목으로 구성됩니다.
[
    "로봇 시스템을 시작합니다",
]
두 경우 모두 " ".join(args.text) 결과는 동일합니다.
20) speak 메서드 호출
engine.speak(" ".join(args.text))speak() 메서드는 입력 문자열을 음성으로 합성하고 즉시 재생합니다.
내부적으로 다음 작업이 수행됩니다.
- 문자열 앞뒤 공백 제거
- 빈 문자열 검사
- Google Cloud TTS 요청 생성
- 음성 모델 설정
- 음성 속도와 높낮이 설정
- Google 서버에 합성 요청
- WAV 형식 음성 데이터 수신
aplay프로세스 실행- 오디오 데이터를 표준 입력으로 전달
- 스피커에서 음성 재생
- 재생 결과 확인
현재 프로그램은 동기 방식으로 실행됩니다.
따라서 음성 재생이 끝날 때까지 프로그램이 종료되지 않습니다.
21) 예외 처리
except Exception as error:engine.speak() 실행 중 발생한 예외를 처리합니다.
현재 코드는 특정 예외만 선택하지 않고 모든 일반 예외를 처리합니다.
예를 들어 다음 예외가 포함될 수 있습니다.
ValueErrorRuntimeError- Google Cloud 인증 예외
- Google API 호출 예외
- 네트워크 관련 예외
- 파일 또는 프로세스 실행 예외
CLI 도구에서는 예외 종류를 사용자에게 모두 노출하기보다, 실행 실패 메시지와 원인을 간단히 표시하는 방식이 실용적입니다.
22) 오류 메시지 출력
print(
    f"TTS 실행 실패: {error}",
    file=sys.stderr,
)
오류가 발생하면 다음 형식으로 메시지를 출력합니다.
TTS 실행 실패: 오류 원인예를 들어 인증 정보가 없으면 다음과 비슷한 메시지가 출력될 수 있습니다.
TTS 실행 실패: Your default credentials were not found오디오 장치가 없으면 다음과 같은 형태가 될 수 있습니다.
TTS 실행 실패: aplay 실행 실패(return code=1): audio open errorfile=sys.stderr가 지정되어 있으므로 일반 출력이 아니라 표준 오류 출력으로 전달됩니다.
23) 표준 출력과 표준 오류 출력의 차이
프로그램에는 일반적으로 다음 두 출력 스트림이 있습니다.
- 표준 출력인
stdout - 표준 오류 출력인
stderr
일반적인 정보는 표준 출력으로 보냅니다.
print("실행 완료")오류 정보는 표준 오류 출력으로 보냅니다.
print(
    "실행 실패",
    file=sys.stderr,
)
두 출력을 분리하면 쉘에서 각각 다르게 처리할 수 있습니다.
정상 출력만 파일에 저장하려면 다음처럼 실행합니다.
python3 say.py 안녕하세요 > output.log오류 출력만 파일에 저장하려면 다음과 같이 실행합니다.
python3 say.py 안녕하세요 2> error.log모든 출력을 하나의 파일에 저장하려면 다음과 같이 실행합니다.
python3 say.py 안녕하세요 > all.log 2>&1시스템 서비스나 자동화 스크립트에서는 표준 출력과 오류 출력을 구분하는 것이 중요합니다.
24) 실패 시 종료 코드 반환
return 1TTS 실행에 실패하면 main() 함수는 1을 반환합니다.
쉘에서는 프로그램의 종료 코드를 이용해 성공과 실패를 판단할 수 있습니다.
실행 직후 다음 명령으로 종료 코드를 확인할 수 있습니다.
echo $?TTS 실행에 실패했다면 다음이 출력됩니다.
1종료 코드는 쉘 스크립트에서 유용합니다.
python3 say.py 시스템 시작

if [ $? -ne 0 ]; then
    echo "음성 출력에 실패했습니다."
fi
더 간단하게 다음처럼 작성할 수도 있습니다.
if ! python3 say.py 시스템 시작; then
    echo "음성 출력에 실패했습니다."
fi
25) 정상 종료 코드 반환
return 0오류 없이 음성 재생이 완료되면 0을 반환합니다.
쉘에서 확인하면 다음과 같습니다.
echo $?결과는 다음과 같습니다.
0종료 코드 0은 일반적으로 정상 실행을 의미합니다.
26) 직접 실행 여부 확인
if __name__ == "__main__":이 조건문은 현재 Python 파일이 직접 실행되었는지 확인합니다.
다음과 같이 실행하면 조건은 참이 됩니다.
python3 say.py 안녕하세요반대로 다른 Python 파일에서 모듈로 가져오면 조건은 거짓이 됩니다.
import google_tts_ros2.tts_cli이 구조를 사용하면 모듈을 가져오는 순간 프로그램이 자동으로 실행되는 것을 방지할 수 있습니다.
27) SystemExit를 이용한 프로그램 종료
raise SystemExit(main())main() 함수의 반환값을 운영체제 종료 코드로 전달합니다.
정상 실행 시 다음과 같습니다.
main()반환값은 0입니다.
raise SystemExit(0)프로그램은 정상 종료합니다.
오류 발생 시에는 다음과 같습니다.
raise SystemExit(1)프로그램은 실패 상태로 종료합니다.
다음 코드도 비슷한 동작을 합니다.
sys.exit(main())하지만 현재 코드는 SystemExit를 명시적으로 발생시키는 방식을 사용합니다.
두 방식 모두 일반적인 Python CLI 프로그램에서 사용됩니다.
28) 가장 기본적인 실행 예제
기본 한국어 음성으로 출력하려면 다음과 같이 실행합니다.
python3 say.py 안녕하세요여러 단어를 입력할 수 있습니다.
python3 say.py 로봇 시스템이 정상적으로 시작되었습니다따옴표로 묶어도 됩니다.
python3 say.py "로봇 시스템이 정상적으로 시작되었습니다"29) 말하기 속도 변경 예제
기본보다 느리게 읽으려면 다음과 같이 실행합니다.
python3 say.py 배터리 잔량을 확인합니다 --speaking-rate 0.8기본보다 빠르게 읽으려면 다음과 같이 실행합니다.
python3 say.py 임무를 시작합니다 --speaking-rate 1.2로봇 안내 음성은 너무 빠르면 내용을 이해하기 어렵습니다.
일반적인 안내 문장에는 0.9에서 1.1 정도가 적당합니다.
30) 음높이 변경 예제
낮은 목소리로 출력하려면 다음과 같이 실행합니다.
python3 say.py 시스템 경고입니다 --pitch -2.0높은 목소리로 출력하려면 다음과 같이 실행합니다.
python3 tts_cli.py 새로운 메시지가 있습니다 --pitch 2.0음높이는 음성 모델에 따라 체감 차이가 다를 수 있습니다.