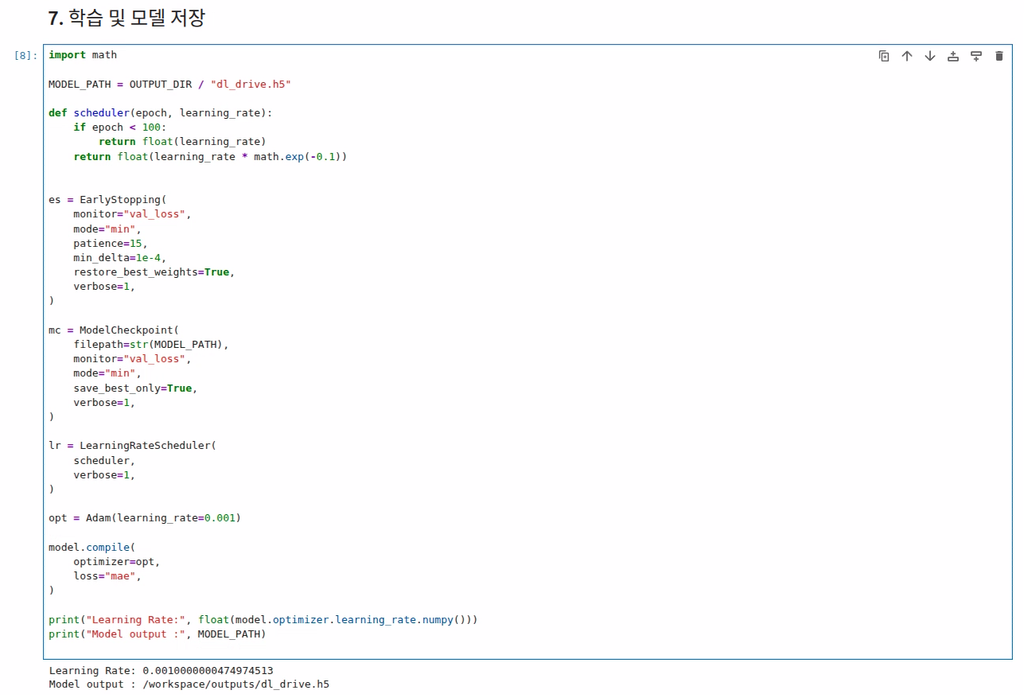
52. Model 저장 위치
다음 코드입니다.
MODEL_PATH = (
    OUTPUT_DIR /
    "dl_drive.h5"
)
기본값은
/workspace/outputs/dl_drive.h5
입니다.
Training 후 실제 LIMO 추론 프로그램에서 사용할 핵심 결과물이 바로 이 파일입니다.
53. Optimizer는 Adam
다음과 같이 설정합니다.
opt = Adam(
    learning_rate=0.001
)
초기 Learning Rate는
0.001
입니다.
Adam Optimizer는 Loss를 줄이도록 Weight를 반복적으로 수정합니다.
전체 흐름은
Image
 ↓
Model
 ↓
Prediction
 ↓
Label과 비교
 ↓
Loss
 ↓
Gradient
 ↓
Adam
 ↓
Weight Update
입니다.
54. Loss Function은 MAE
Model Compile 부분입니다.
model.compile(
    optimizer=opt,
    loss="mae",
)
mae는
Mean Absolute Error
입니다.
예를 들어 실제 Label이
[0.5, 0.8]
인데 Model이
[0.4, 0.6]
이라고 예측했다고 가정합니다.
오차는
|0.5 - 0.4| = 0.1

|0.8 - 0.6| = 0.2
이고 평균은
(0.1 + 0.2) / 2
= 0.15
입니다.
Model Training은 이 MAE가 작아지는 방향으로 진행됩니다.
55. 왜 Accuracy가 출력되지 않는가
Training Log를 보면
loss
val_loss
는 있지만 Classification에서 많이 보는
accuracy
val_accuracy
가 없습니다.
이유는 이 문제가 Classification이 아니라 Regression이기 때문입니다.
즉
정답 Class를 맞혔나?
가 아니라
예측한 두 숫자가
실제 숫자와 얼마나 가까운가?
를 평가합니다.
따라서 MAE를 사용하는 것이 자연스럽습니다.
56. Learning Rate Scheduler
다음 Scheduler를 정의합니다.
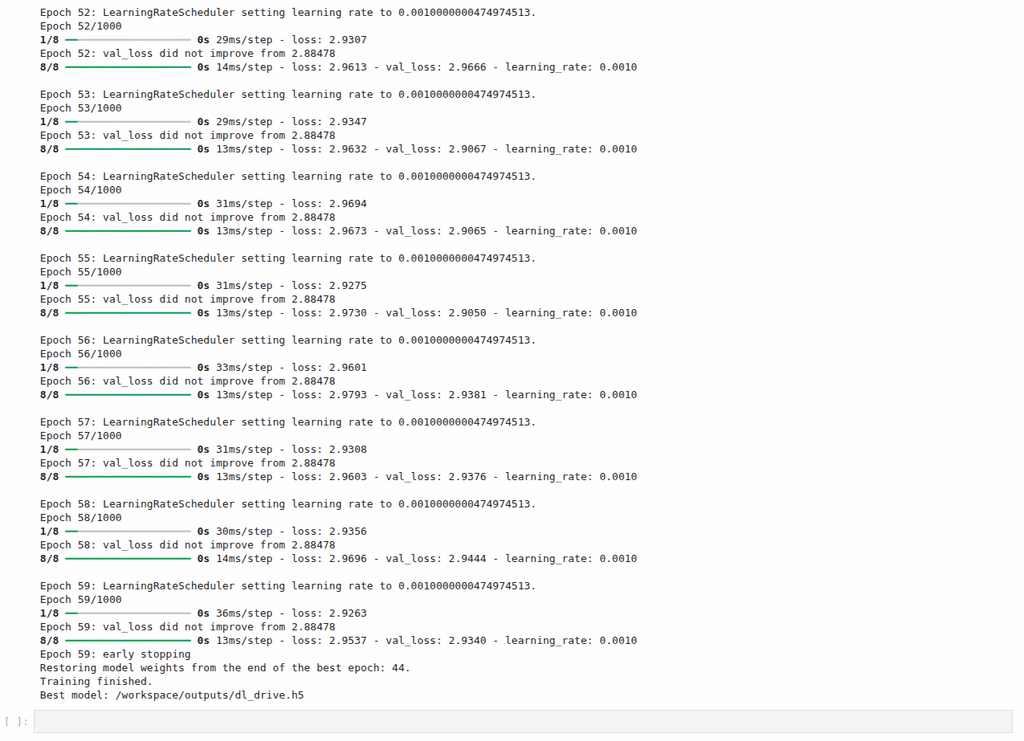
def scheduler(
    epoch,
    learning_rate
):
    if epoch < 100:
        return float(learning_rate)

    return float(
        learning_rate *
        math.exp(-0.1)
    )
초기 약 100 Epoch 동안은 Learning Rate를 그대로 유지합니다.
LR = 0.001
그 이후에는 매 Epoch마다
현재 LR × e^-0.1
을 적용합니다.
e^-0.1은 약
0.9048
입니다.
따라서 Scheduler가 실제 감소 단계에 들어가면 대략
0.001
 ↓
0.0009048
 ↓
0.0008187
 ↓
0.0007408
 ↓
...
처럼 감소합니다.
57. Epoch 숫자에 주의한다
Keras Callback에서 전달되는 epoch 값은 0부터 시작합니다.
따라서
if epoch < 100
은 내부 Index
0 ~ 99
까지 Learning Rate를 유지한다는 의미입니다.
화면에 표시되는 Epoch 기준으로는 대략
Epoch 1 ~ Epoch 100
까지 유지되고 그 다음부터 감소한다고 이해하면 됩니다.
58. EarlyStopping
이 Notebook에는 이미 EarlyStopping이 들어 있습니다.
es = EarlyStopping(
    monitor="val_loss",
    mode="min",
    patience=15,
    min_delta=1e-4,
    restore_best_weights=True,
    verbose=1,
)
매우 중요한 설정입니다.
epochs=1000이라고 되어 있지만 실제로 반드시 1000 Epoch까지 학습하는 것은 아닙니다.
Validation Loss가 충분히 개선되지 않으면 자동으로 중단됩니다.
59. monitor=”val_loss”
EarlyStopping은
Training Loss
가 아니라
Validation Loss
를 감시합니다.
이것이 중요합니다.
Training Data를 얼마나 잘 외웠는지가 아니라 학습에 직접 사용하지 않은 Validation Data에서도 잘 동작하는지를 확인하기 때문입니다.
60. patience=15
patience=15
는 Validation Loss가 개선되지 않아도 즉시 중단하지 않고 15 Epoch를 기다린다는 뜻입니다.
예를 들어
Epoch 16
Best val_loss
가 나온 후
Epoch 17
개선 없음

Epoch 18
개선 없음

...

15 Epoch 동안 개선 없음
이라면 Training을 중단할 수 있습니다.
즉 일시적으로 Validation Loss가 나빠졌다고 바로 중단하지 않습니다.
61. min_delta=1e-4
다음 값이 있습니다.
min_delta=1e-4
즉 아주 미세한 변화는 개선으로 판단하지 않습니다.
1e-4
=
0.0001
보다 의미 있게 개선되어야 EarlyStopping의 개선으로 인정합니다.
62. restore_best_weights=True
매우 중요한 옵션입니다.
restore_best_weights=True
Training 마지막 Epoch의 Weight를 사용하는 것이 아니라 Validation Loss가 가장 좋았던 시점의 Weight를 복원합니다.
즉
Epoch 16
val_loss = 가장 좋음
       ↓
Epoch 17~31
더 나빠짐
       ↓
Early Stop
       ↓
Epoch 16 Weight 복원
형태가 됩니다.
63. ModelCheckpoint
다음 Callback도 사용합니다.
mc = ModelCheckpoint(
    filepath=str(MODEL_PATH),
    monitor="val_loss",
    mode="min",
    save_best_only=True,
    verbose=1,
)
이 Callback은 Validation Loss가 좋아질 때만 Model을 저장합니다.
예를 들어
Epoch 1
val_loss = 3.53
→ 저장

Epoch 2
val_loss = 3.43
→ 더 좋음
→ 저장

Epoch 3
val_loss = 3.35
→ 저장

Epoch 4
val_loss = 3.39
→ 나빠짐
→ 저장 안 함
방식입니다.
64. EarlyStopping과 ModelCheckpoint의 역할 차이
두 기능은 비슷해 보이지만 역할이 다릅니다.
EarlyStopping
→ 언제 Training을 끝낼 것인가?
ModelCheckpoint
→ 어떤 Model을 파일로 저장할 것인가?
따라서 둘을 함께 사용하는 것이 좋습니다.
   Training
       ↓
  val_loss 확인
       ↓
   좋아짐?
 ┌─┴─┐
YES       NO
 │        │
저장    기다림
 │        │
 └─→ EarlyStopping 판단
65. LearningRateScheduler Callback
Scheduler Function을 실제 Training에 연결합니다.
lr = LearningRateScheduler(
    scheduler,
    verbose=1
)
그래서 Training Log에서 다음 메시지가 나타납니다.
Epoch 1:
LearningRateScheduler
setting learning rate to 0.001...
이것은 Error가 아니라 정상적인 Callback 동작입니다.
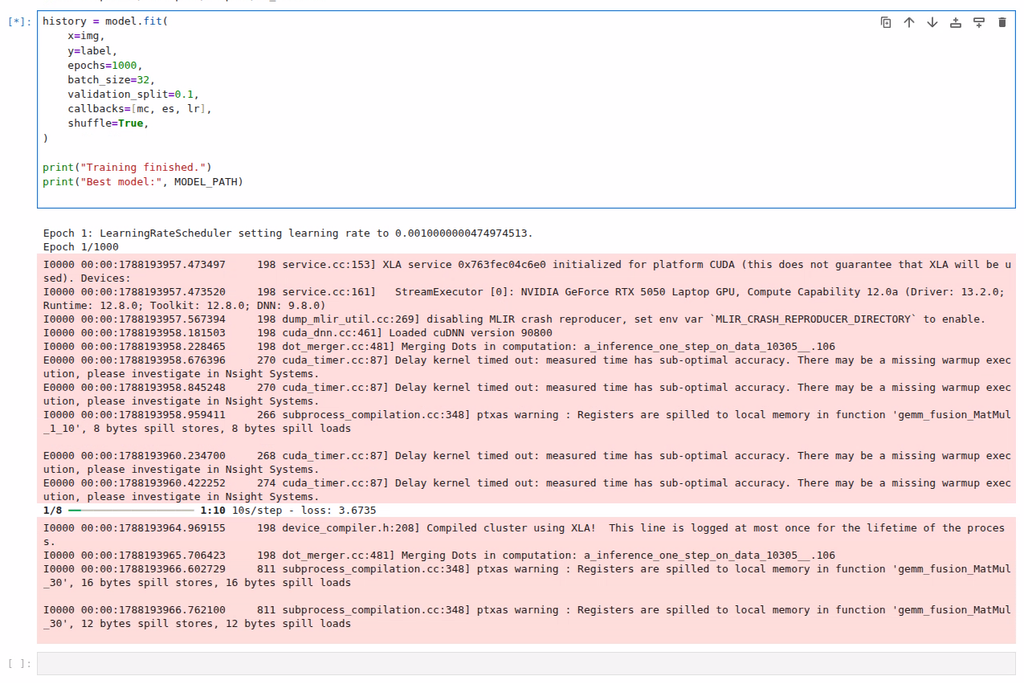
66. 실제 Model Training
핵심 코드입니다.
history = model.fit(
    x=img,
    y=label,
    epochs=1000,
    batch_size=32,
    validation_split=0.1,
    callbacks=[mc, es, lr],
    shuffle=True,
)
이 한 줄이 실제 Deep Learning Training을 수행합니다.
67. x=img
x=img
는 Input Dataset입니다.
Shape는
N × 110 × 300 × 3
입니다.
즉 Camera ROI Image입니다.
68. y=label
y=label
은 정답입니다.
Shape는
N × 2
입니다.
즉 각 Image마다 두 개의 정답값을 가지고 있습니다.
전체 관계는
Image 1
→ Label [a1, b1]

Image 2
→ Label [a2, b2]

Image 3
→ Label [a3, b3]
입니다.
69. epochs=1000의 실제 의미
epochs=1000
은 최대 1000 Epoch까지 Training할 수 있다는 의미입니다.
하지만 앞에서
EarlyStopping
patience = 15
를 설정했기 때문에 Validation Loss가 더 이상 좋아지지 않으면 훨씬 일찍 Training이 끝날 수 있습니다.
따라서
epochs=1000
을
반드시 1000번 학습
이라고 이해하면 안 됩니다.
정확하게는
최대 1000 Epoch
+
Validation 성능이 멈추면 조기 종료
입니다.
70. Batch Size는 32
batch_size=32
입니다.
즉 한 번 Weight를 Update할 때 최대 32개의 Sample을 묶어서 사용합니다.
Image 1
Image 2
...
Image 32
     ↓
하나의 Batch
     ↓
Forward
     ↓
Loss
     ↓
Backpropagation
     ↓
Weight Update
입니다.
71. 로그에서 8/8가 의미하는 것
사용자의 실제 Training Log에서는
8/8
가 표시되었습니다.
이는 한 Epoch에 Training Step이 8개라는 뜻입니다.
Batch Size가 32라면 실제 Training Sample 수와 Validation Split 조건에 따라 이와 같은 Step 수가 만들어질 수 있습니다.
중요한 것은 8/8 자체가 Error가 아니라는 점입니다.
72. validation_split=0.1
validation_split=0.1
은 전체 Dataset 중 10%를 Validation에 사용합니다.
개념적으로
전체 Dataset
     ↓
90%
Training
     +
10%
Validation
입니다.
Training Dataset은 Weight를 수정하는 데 사용하고 Validation Dataset은 학습되지 않은 데이터에 대한 성능을 평가합니다.
73. Validation Split에서 주의할 점
이 소스는 먼저
file_list = sorted(...)
를 사용합니다.
그리고 model.fit()에서
validation_split=0.1
을 사용합니다.
Array를 직접 전달하는 Keras Training에서는 Validation Split이 입력 데이터의 뒤쪽 일부를 Validation으로 분리하는 방식으로 동작합니다.
따라서 파일 이름이 촬영 순서와 연결되어 있다면 마지막 부분의 Frame들이 Validation에 몰릴 가능성이 있습니다.
예를 들어
001.jpg
002.jpg
003.jpg
...
1000.jpg
가 실제 주행 순서라면 마지막 약 10%가 하나의 특정 Track 구간일 수도 있습니다.
74. shuffle=True
다음 설정이 있습니다.
shuffle=True
Training Sample의 순서를 섞습니다.
예를 들어 원래
직진
직진
직진
좌회전
좌회전
우회전
...
처럼 연속되어 있었다면 Training 과정에서 Sample 순서를 섞어 특정 순서에 지나치게 영향을 받는 것을 줄일 수 있습니다.
다만 앞에서 설명한 validation_split 구성과 Training Shuffle은 별개의 문제입니다.
75. Training History
model.fit()의 반환값은
history
에 저장됩니다.
여기에는 Epoch별 Training 결과가 들어 있습니다.
예를 들어
history.history["loss"]
에는 Training Loss가 있습니다.
history.history["val_loss"]
에는 Validation Loss가 있습니다.
따라서 다음과 같은 Graph를 만들 수 있습니다.
Loss
 │
 │\
 │ \
 │  \____ Training
 │
 │   \___/\__ Validation
 │
 └──────────────── Epoch
이 Graph는 Overfitting 판단에 매우 중요합니다.
76. 실제 Training Log를 해석하는 방법
실제 학습 결과에서 다음과 같은 패턴이 나타날 수 있습니다.
Epoch 1
loss = 3.6959
val_loss = 3.5354
초기에는 Loss가 높습니다.
학습이 진행되면서
Epoch 7
loss = 3.4558
val_loss = 3.2260
처럼 감소합니다.
그리고 어떤 시점에서
val_loss improved
가 나오면 ModelCheckpoint가 새로운 Best Model을 저장합니다.
77. val_loss improved의 의미
예를 들어
Epoch 16:

val_loss improved
from 3.25870
to 3.18144

saving model to
/workspace/outputs/dl_drive.h5
라고 출력되었다면
이전 Best Validation Loss
3.25870

현재 Validation Loss
3.18144
이므로 현재 Model이 더 좋다는 뜻입니다.
따라서
dl_drive.h5
를 새 Model로 교체합니다.
78. val_loss did not improve는 Error가 아니다
다음 메시지도 자주 나타납니다.
val_loss did not improve
이것은 Error가 아닙니다.
단순히 이번 Epoch의 Validation 성능이 Best Model보다 좋지 않았다는 뜻입니다.
따라서
현재 Weight
→ 학습에는 사용

저장 파일
→ 기존 Best 유지
가 됩니다.
79. Training Loss와 Validation Loss를 함께 봐야 한다
다음과 같은 상황을 생각해 보겠습니다.
Training Loss
계속 감소

Validation Loss
감소하다가 증가
예:
Epoch 10
loss     = 3.0835
val_loss = 3.2786

Epoch 20
loss     = 2.9994
val_loss = 3.6143

Epoch 59
loss     = 2.9537
val_loss = 더 이상 개선 없음
Training Dataset에서는 계속 좋아지고 있지만 Validation Dataset에서는 좋아지지 않습니다.
이것은 Overfitting, 과적합의 시작 신호일 수 있습니다.
그래서 이 코드에 EarlyStopping과 ModelCheckpoint가 들어 있는 것입니다.
80. 최종 Model 파일
Training이 완료되면
/workspace/outputs/dl_drive.h5
가 핵심 결과물입니다.
이 파일 안에는
Model Architecture

Weight

Training 관련 설정
등 Keras Model 정보가 저장될 수 있습니다.
실제 주행 프로그램에서는 대략 다음과 같이 Load할 수 있습니다.
import tensorflow as tf

model = tf.keras.models.load_model(
    "/workspace/outputs/dl_drive.h5"
)
81. 실제 LIMO에서 Model을 사용할 때의 기본 구조
Training이 끝났다면 다음 단계가 필요합니다.
LIMO Camera
     ↓
ROS 2 Camera Topic
     ↓
cv_bridge
     ↓
OpenCV Image
     ↓
Training과 동일한 ROI
     ↓
110 × 300 × 3
     ↓
dl_drive.h5
     ↓
Model Prediction
     ↓
2개의 값
     ↓
주행 방향 계산
     ↓
geometry_msgs/msg/Twist
     ↓
/cmd_vel
     ↓
LIMO
이 부분은 현재 Training Notebook에는 포함되어 있지 않으며 별도의 ROS 2 추론 및 주행 Node가 담당해야 합니다.
82. 실제 주행에서 가장 중요한 것은 동일한 전처리다
Training이 다음 조건이었다는 사실을 기억해야 합니다.
OpenCV BGR

ROI:
Y = 190 ~ 299
X = 0 ~ 299

Size:
110 × 300 × 3

Image:
uint8, 0~255

Label:
원본 / 300
Inference에서도 가능하면 동일한 조건을 유지해야 합니다.
Training Input
==
Inference Input
이것이 매우 중요합니다.
83. Prediction 값의 Scale도 주의해야 한다
Training Label에서는
label = label / 300.0
을 사용합니다.
따라서 Model의 Prediction 역시 정규화된 Scale입니다.
예를 들어
pred = model.predict(image)
결과가
[0.4, 0.7]
이라면 원래 Label Scale을 복원해야 하는 시스템에서는 개념적으로
0.4 × 300 = 120

0.7 × 300 = 210
처럼 역변환이 필요할 수 있습니다.
다만 현재 Training Notebook 자체에는 Prediction 값을 원래 Scale로 복원하는 코드가 들어 있지 않습니다.
따라서 실제 ROS 2 주행 코드에서 두 출력값을 어떤 의미로 사용하는지는 주행 Node와 함께 확인해야 합니다.