TurtleBot3 Burger에 스피커를 연결하면 단순한 비프음뿐만 아니라 현재 상태, 경고, 작업 결과를 실제 음성으로 안내할 수 있습니다.
예를 들어 다음과 같은 상황에서 음성 안내를 활용할 수 있습니다.
- 로봇이 출발하거나 목적지에 도착했을 때
- 장애물을 감지했을 때
- 배터리 잔량이 부족할 때
- 자율주행이나 작업이 완료되었을 때
- 사용자의 명령을 정상적으로 처리했을 때
- 센서나 모터 오류가 발생했을 때
이 글에서는 ROS 2 Humble을 사용하는 TurtleBot3 Burger에서 Google Cloud Text-to-Speech API를 이용해 다음 기능을 구현합니다.
- 터미널에서 입력한 문자열을 즉시 음성으로 출력
- ROS 2
std_msgs/msg/String토픽으로 문자열을 받아 음성 출력 - 음성 종류, 속도, 높이, 볼륨을 ROS 2 파라미터로 설정
- 여러 문자열이 연속으로 들어올 때 순서대로 재생
- USB 스피커와 ALSA 오디오 장치 선택
Google Cloud Text-to-Speech는 일반 텍스트 또는 SSML을 입력받아 음성 데이터를 생성하며, Python 클라이언트 라이브러리는 Application Default Credentials, ADC 방식으로 인증할 수 있습니다.
1. 전체 시스템 구성
이번에 구현할 시스템의 흐름은 다음과 같습니다.
ROS 2 노드 또는 ros2 topic pub
            │
            ▼
     /tts 토픽
 std_msgs/msg/String
            │
            ▼
  google_tts_node
            │
            ▼
Google Cloud Text-to-Speech API
            │
            ▼
   LINEAR16 음성 데이터
            │
            ▼
        aplay
            │
            ▼
 USB 스피커 또는 오디오 장치
ROS 2 노드는 /tts 토픽을 구독합니다. 문자열 메시지를 받으면 Google Cloud Text-to-Speech API로 전송하고, 반환된 음성 데이터를 Linux의 aplay 명령으로 재생합니다.
ROS 2에서 Publisher와 Subscriber가 통신하려면 토픽 이름과 메시지 형식이 일치해야 합니다. 이번 구현에서는 기본 문자열 메시지인 std_msgs/msg/String을 사용합니다.
2. 개발 환경
이 글에서 사용하는 환경은 다음과 같습니다.
Robot        : TurtleBot3 Burger
Computer     : Raspberry Pi 또는 TurtleBot3 SBC
OS           : Ubuntu 22.04
ROS          : ROS 2 Humble
Language     : Python 3
Audio        : USB 오디오 동글 또는 USB 스피커
Cloud API    : Google Cloud Text-to-Speech
ROS 2 Humble의 대표 지원 환경은 Ubuntu 22.04이며 Python과 C++ 클라이언트를 사용할 수 있습니다.
TurtleBot3 Burger에는 기본적으로 일반 PC와 같은 내장 스피커가 없기 때문에 별도의 USB 오디오 장치나 USB 스피커를 연결하는 것이 가장 간단합니다.
블루투스 스피커도 사용할 수 있지만, 부팅 후 자동 연결과 PulseAudio 또는 PipeWire 설정이 추가로 필요하므로 로봇에서는 USB 오디오 장치를 권장합니다.
3. Google Cloud 프로젝트 준비 및 인증 파일을 TurtleBot3로 복사
아래의 사이트를 참조하세요
4. Google Cloud Python 라이브러리 설치
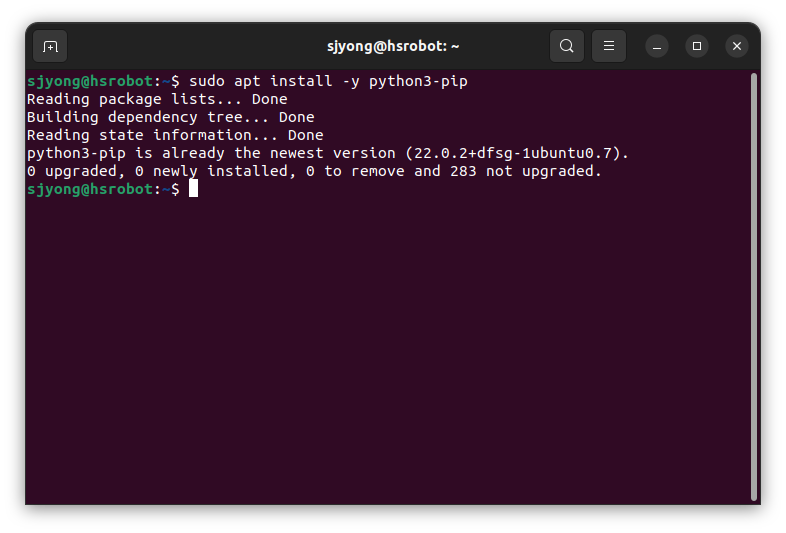
Python 패키지 관리 도구를 설치합니다.
sudo apt install -y python3-pip
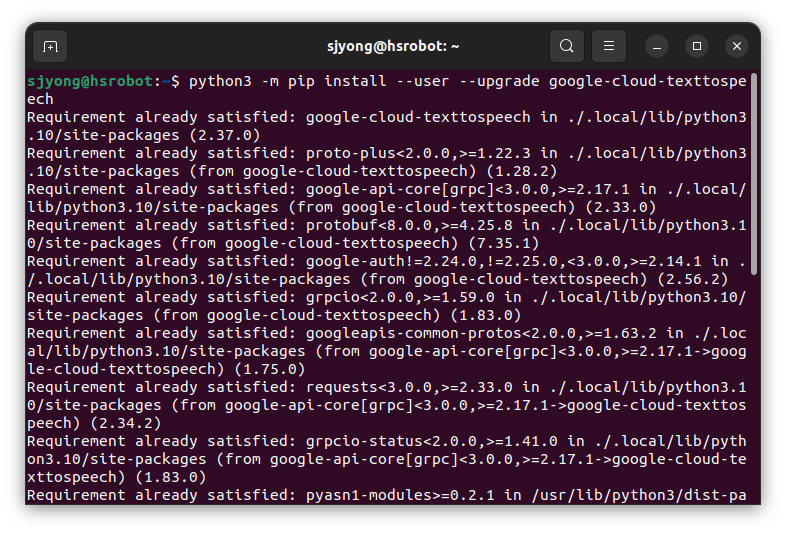
Google Cloud Text-to-Speech 클라이언트 라이브러리를 설치합니다.
python3 -m pip install --user --upgrade google-cloud-texttospeech
설치를 확인합니다.
python3 -c "from google.cloud import texttospeech; print('Google Cloud TTS library OK')"
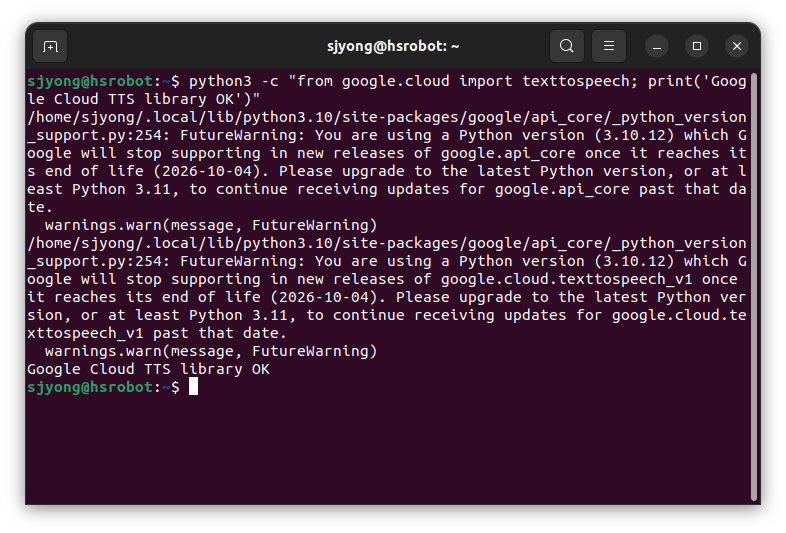
다음 메시지가 출력되면 정상입니다.
Google Cloud TTS library OK
Google 공식 Python 예제에서도 google.cloud.texttospeech 모듈의 TextToSpeechClient를 생성하고 synthesize_speech()를 호출하는 방식을 사용합니다.
sudo pip install은 시스템 Python 환경과 ROS 2 패키지 환경을 손상시킬 수 있으므로 사용하지 않는 편이 좋습니다.
7. ROS 2 Python 패키지 생성
ROS 2 Python 패키지를 생성합니다.
cd ~/turtlebot3_ws/src

ros2 pkg create --build-type ament_python \
  --license Apache-2.0 google_tts_ros2 --dependencies rclpy std_msgs
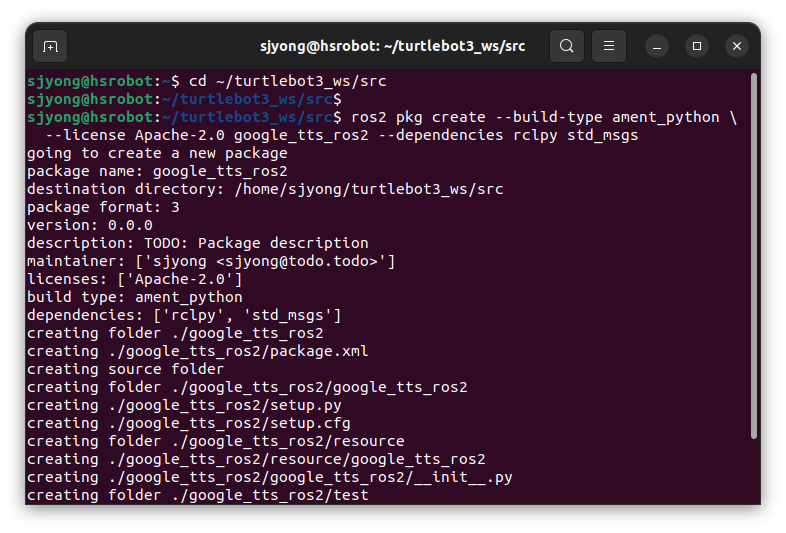
ROS 2에서는 ament_python 빌드 형식으로 Python 패키지를 만들 수 있으며 rclpy와 std_msgs를 실행 의존성으로 사용합니다.
필요한 디렉터리와 파일을 생성합니다.
cd ~/turtlebot3_ws/src/google_tts_ros2

mkdir -p launch

touch google_tts_ros2/tts_engine.py
touch google_tts_ros2/tts_node.py
touch google_tts_ros2/say.py
touch launch/tts.launch.py
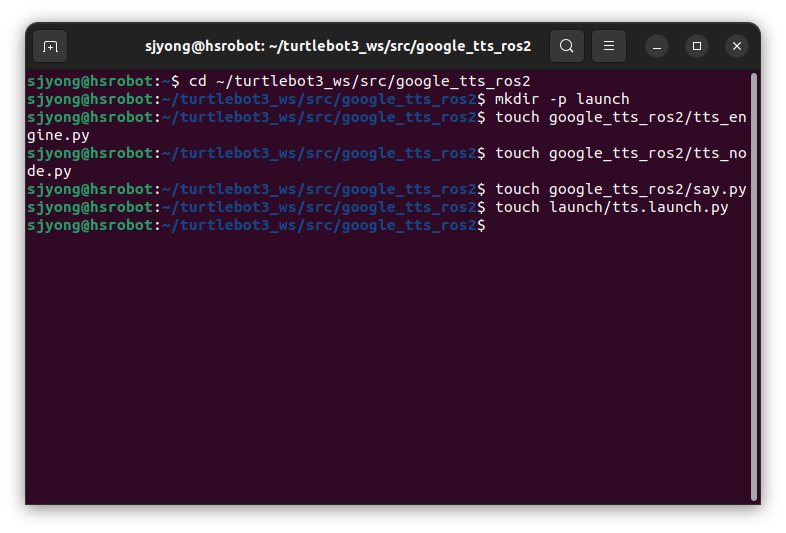
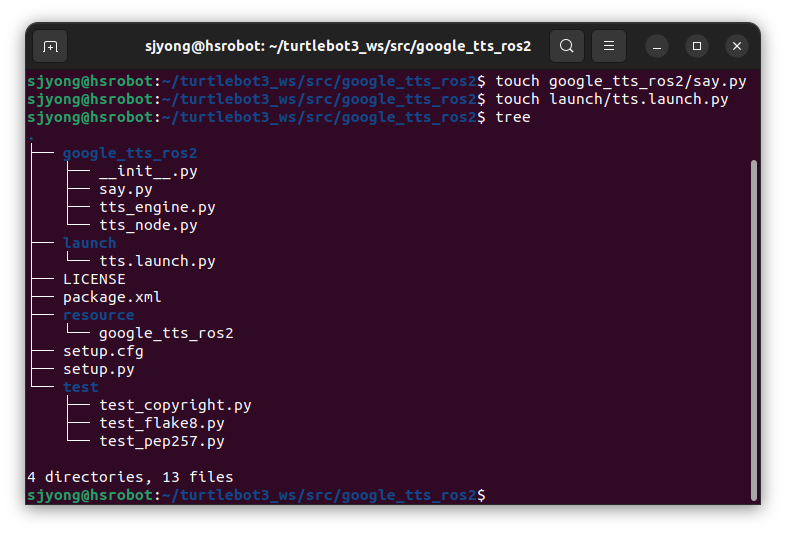
최종 디렉터리 구조는 다음과 같습니다.
google_tts_ros2/
├── google_tts_ros2/
│   ├── __init__.py
│   ├── tts_engine.py
│   └── tts_node.py
├── launch/
│   └── tts.launch.py
├── resource/
│   └── google_tts_ros2
├── package.xml
├── setup.cfg
└── setup.py
8. Google Cloud TTS 처리 클래스 작성
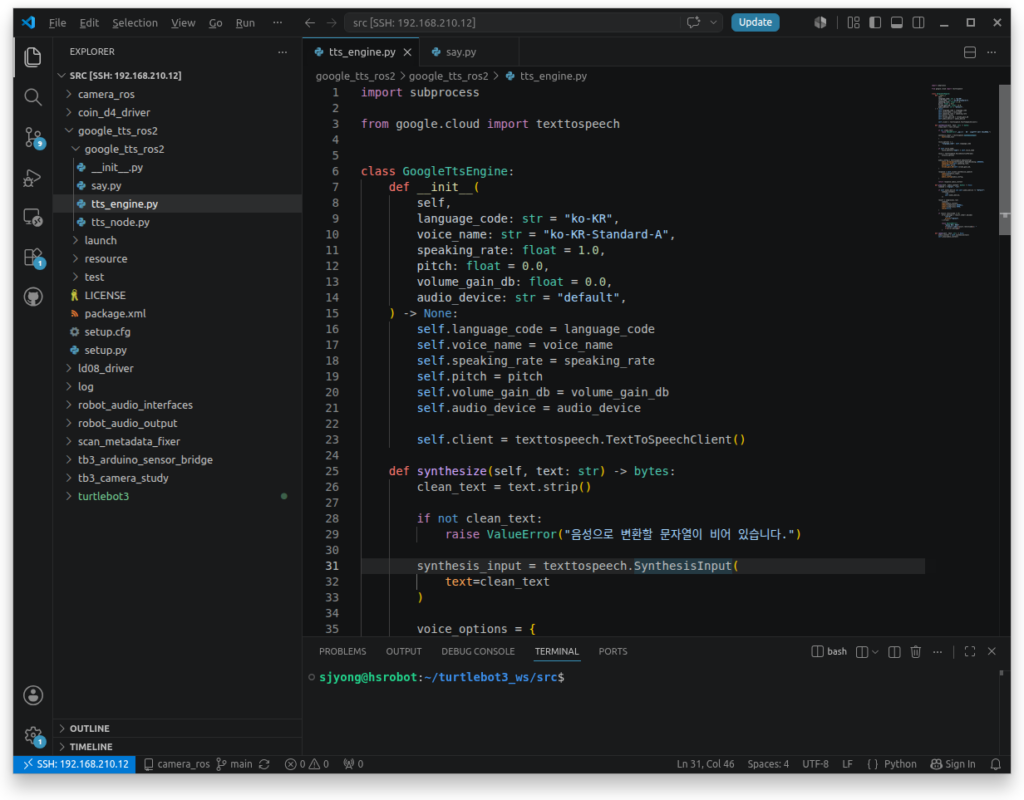
google_tts_ros2/tts_engine.py 파일을 작성합니다.
import subprocess

from google.cloud import texttospeech


class GoogleTtsEngine:
    def __init__(
        self,
        language_code: str = "ko-KR",
        voice_name: str = "ko-KR-Standard-A",
        speaking_rate: float = 1.0,
        pitch: float = 0.0,
        volume_gain_db: float = 0.0,
        audio_device: str = "default",
    ) -> None:
        self.language_code = language_code
        self.voice_name = voice_name
        self.speaking_rate = speaking_rate
        self.pitch = pitch
        self.volume_gain_db = volume_gain_db
        self.audio_device = audio_device

        self.client = texttospeech.TextToSpeechClient()

    def synthesize(self, text: str) -> bytes:
        clean_text = text.strip()

        if not clean_text:
            raise ValueError("음성으로 변환할 문자열이 비어 있습니다.")

        synthesis_input = texttospeech.SynthesisInput(
            text=clean_text
        )

        voice_options = {
            "language_code": self.language_code
        }

        if self.voice_name:
            voice_options["name"] = self.voice_name

        voice = texttospeech.VoiceSelectionParams(
            **voice_options
        )

        audio_config = texttospeech.AudioConfig(
            audio_encoding=texttospeech.AudioEncoding.LINEAR16,
            speaking_rate=self.speaking_rate,
            pitch=self.pitch,
            volume_gain_db=self.volume_gain_db,
        )

        response = self.client.synthesize_speech(
            input=synthesis_input,
            voice=voice,
            audio_config=audio_config,
        )

        return response.audio_content

    def play(self, audio_content: bytes) -> None:
        command = ["aplay", "-q"]

        if self.audio_device and self.audio_device != "default":
            command.extend([
                "-D",
                self.audio_device,
            ])

        result = subprocess.run(
            command,
            input=audio_content,
            stdout=subprocess.DEVNULL,
            stderr=subprocess.PIPE,
            check=False,
        )

        if result.returncode != 0:
            error_message = result.stderr.decode(
                "utf-8",
                errors="replace",
            ).strip()

            raise RuntimeError(
                "aplay 실행 실패"
                f"(return code={result.returncode}): "
                f"{error_message}"
            )

    def speak(self, text: str) -> None:
        audio_content = self.synthesize(text)
        self.play(audio_content)
1) subprocess 모듈의 역할
소스 코드의 첫 번째 줄에서는 Python 표준 라이브러리인 subprocess를 가져옵니다.
import subprocesssubprocess 모듈은 Python 프로그램에서 외부 명령어나 다른 프로그램을 실행할 때 사용합니다.
이 코드에서는 다음 Linux 명령어를 실행하기 위해 사용합니다.
aplay -qaplay는 WAV 형식의 오디오 데이터를 재생하는 ALSA 기반 명령어입니다.
Python 코드에서는 음성 데이터를 파일로 저장하지 않고 aplay 프로세스의 표준 입력으로 직접 전달합니다.
이 방식의 장점은 다음과 같습니다.
- 임시 WAV 파일을 만들 필요가 없습니다.
- 파일 삭제 처리가 필요하지 않습니다.
- 저장 장치에 불필요한 쓰기가 발생하지 않습니다.
- 음성 생성 후 바로 재생할 수 있습니다.
- 반복 음성 출력 시스템을 단순하게 구현할 수 있습니다.
2) Google Text-to-Speech 모듈 가져오기
다음 코드는 Google Cloud Text-to-Speech 라이브러리를 가져옵니다.
from google.cloud import texttospeech이 모듈에서는 다음 기능을 사용합니다.
TextToSpeechClientSynthesisInputVoiceSelectionParamsAudioConfigAudioEncoding
각 객체는 음성 생성 요청의 특정 설정을 담당합니다.
3) GoogleTtsEngine 클래스
class GoogleTtsEngine:GoogleTtsEngine 클래스는 음성 합성에 필요한 설정과 동작을 하나의 객체로 관리합니다.
클래스 내부 기능은 크게 다음과 같이 나뉩니다.
- 초기 설정과 클라이언트 생성
- 문자열을 음성 데이터로 변환
- 음성 데이터 재생
- 합성과 재생을 한 번에 실행
이러한 구조를 사용하면 다른 Python 프로그램이나 ROS 2 노드에서 쉽게 재사용할 수 있습니다.
예를 들어 다음처럼 객체를 한 번 생성한 뒤 여러 문장을 출력할 수 있습니다.
tts = GoogleTtsEngine()

tts.speak("시스템을 시작합니다.")
tts.speak("배터리 상태가 정상입니다.")
tts.speak("임무를 시작합니다.")
4) 생성자 메서드 구조
클래스의 생성자는 다음과 같습니다.
def __init__(
    self,
    language_code: str = "ko-KR",
    voice_name: str = "ko-KR-Standard-A",
    speaking_rate: float = 1.0,
    pitch: float = 0.0,
    volume_gain_db: float = 0.0,
    audio_device: str = "default",
) -> None:
생성자는 음성 합성에 사용할 기본 옵션을 전달받습니다.
Python 타입 힌트를 사용하여 각 인수의 예상 자료형도 명확하게 표시하고 있습니다.
language_code: str
speaking_rate: float
-> None은 생성자 메서드가 별도의 값을 반환하지 않는다는 의미입니다.
5) language_code 설정
language_code: str = "ko-KR"language_code는 음성을 합성할 언어와 지역을 지정합니다.
기본값인 ko-KR은 대한민국 한국어를 의미합니다.
대표적인 언어 코드는 다음과 같습니다.
ko-KR: 한국어en-US: 미국 영어en-GB: 영국 영어ja-JP: 일본어zh-CN: 중국어 간체de-DE: 독일어fr-FR: 프랑스어
한국어 문장을 출력할 때는 일반적으로 ko-KR을 사용합니다.
tts = GoogleTtsEngine(
    language_code="ko-KR"
)
6) voice_name 설정
voice_name: str = "ko-KR-Standard-A"voice_name은 실제로 사용할 음성 모델을 지정합니다.
언어 코드만 지정하면 Google Cloud가 해당 언어에 맞는 기본 음성을 선택할 수 있습니다. 하지만 음성 이름까지 지정하면 원하는 목소리를 명확하게 선택할 수 있습니다.
이 코드에서는 기본값으로 다음 음성을 사용합니다.
ko-KR-Standard-A음성 모델에 따라 다음 요소가 달라질 수 있습니다.
- 남성 또는 여성 음성
- 목소리의 높낮이
- 발음의 자연스러움
- 음성 생성 비용
- 지원되는 기능
- 응답 속도
음성 이름을 빈 문자열로 전달하면 언어 코드만 사용하도록 설계되어 있습니다.
tts = GoogleTtsEngine(
    voice_name=""
)
7) speaking_rate 설정
speaking_rate: float = 1.0speaking_rate는 음성 재생 속도를 조절합니다.
기본값 1.0은 원래 속도를 의미합니다.
speaking_rate=0.8위 설정은 기본보다 느리게 읽도록 합니다.
speaking_rate=1.2위 설정은 기본보다 빠르게 읽도록 합니다.
안내 방송이나 경고 메시지는 너무 빠르게 출력하면 사용자가 내용을 놓칠 수 있습니다. 따라서 장비 상태 안내에는 일반적으로 0.9에서 1.1 정도의 값이 무난합니다.
예제는 다음과 같습니다.
tts = GoogleTtsEngine(
    speaking_rate=0.95
)
8) pitch 설정
pitch: float = 0.0pitch는 음성의 높낮이를 조절합니다.
기본값 0.0은 원래 음높이를 의미합니다.
양수 값을 사용하면 목소리가 높아지고, 음수 값을 사용하면 목소리가 낮아집니다.
tts = GoogleTtsEngine(
    pitch=-2.0
)
위 설정은 기본보다 낮은 음성으로 출력합니다.
tts = GoogleTtsEngine(
    pitch=2.0
)
위 설정은 기본보다 높은 음성으로 출력합니다.
장비 경고음이나 시스템 안내음은 지나치게 높은 목소리보다 중립적이거나 약간 낮은 목소리가 듣기 편한 경우가 많습니다.
9) volume_gain_db 설정
volume_gain_db: float = 0.0volume_gain_db는 생성되는 음성의 볼륨 증폭 값을 데시벨 단위로 설정합니다.
기본값 0.0은 볼륨을 추가로 증폭하거나 감소시키지 않는다는 의미입니다.
volume_gain_db=3.0위 설정은 음량을 증가시킵니다.
volume_gain_db=-3.0위 설정은 음량을 감소시킵니다.
다만 음성 합성 단계의 볼륨 조절과 실제 운영체제의 스피커 볼륨은 서로 다른 개념입니다.
최종 출력 크기는 다음 요소의 영향을 받습니다.
- Google TTS의
volume_gain_db - Linux ALSA 믹서 볼륨
- USB 오디오 장치의 출력 수준
- 앰프의 증폭률
- 스피커 자체 출력
ALSA 볼륨 상태는 다음 명령어로 확인할 수 있습니다.
alsamixer10) audio_device 설정
audio_device: str = "default"audio_device는 aplay가 사용할 ALSA 출력 장치를 지정합니다.
기본값 default를 사용하면 시스템의 기본 오디오 장치로 재생합니다.
USB 오디오 장치나 HDMI 오디오 장치를 직접 선택해야 하는 경우 장치 이름을 설정할 수 있습니다.
사용 가능한 ALSA 장치는 다음 명령어로 확인합니다.
aplay -L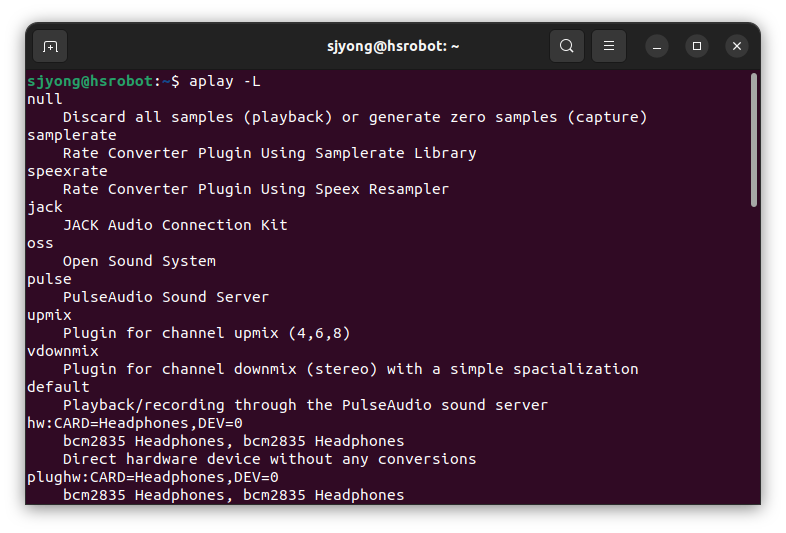
하드웨어 장치 목록은 다음 명령어로 확인할 수 있습니다.
aplay -l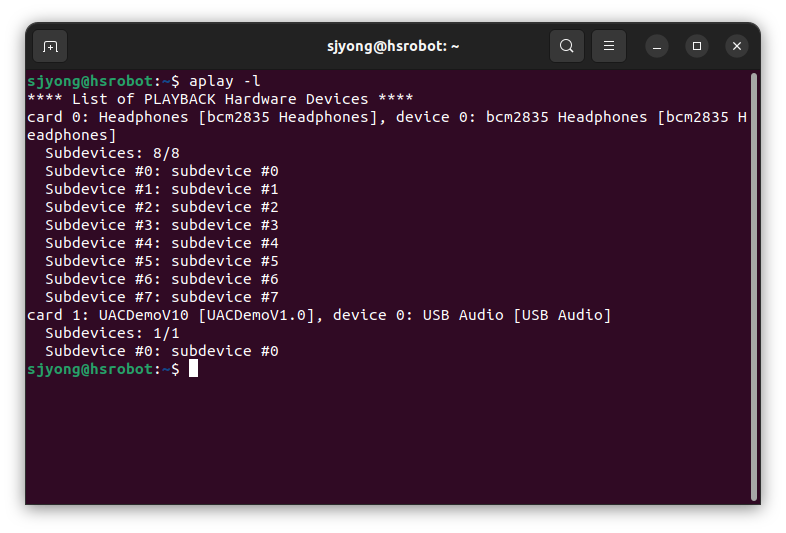
예를 들어 장치 이름이 plughw:2,0이라면 다음처럼 객체를 생성할 수 있습니다.
tts = GoogleTtsEngine(
    audio_device="plughw:2,0"
)
Jetson이나 Raspberry Pi처럼 여러 오디오 출력 장치가 연결된 시스템에서는 장치를 명시적으로 지정하는 편이 안정적입니다.
11) 인스턴스 변수 저장
생성자로 전달받은 값은 다음과 같이 인스턴스 변수에 저장됩니다.
self.language_code = language_code
self.voice_name = voice_name
self.speaking_rate = speaking_rate
self.pitch = pitch
self.volume_gain_db = volume_gain_db
self.audio_device = audio_deviceself는 현재 생성된 GoogleTtsEngine 객체 자신을 의미합니다.
예를 들어 다음 객체를 생성하면
tts = GoogleTtsEngine(
    speaking_rate=1.1
)
객체 내부에는 다음 값이 저장됩니다.
tts.speaking_rate결과는 다음과 같습니다.
1.112) Google Cloud 클라이언트 생성
self.client = texttospeech.TextToSpeechClient()이 코드는 Google Cloud Text-to-Speech API와 통신하기 위한 클라이언트 객체를 생성합니다.
클라이언트는 이후 다음 작업을 수행합니다.
- 인증 정보 확인
- Google Cloud 서버 연결
- 음성 합성 요청 전송
- 응답 데이터 수신
- API 오류 전달
클라이언트를 생성자에서 한 번만 생성하기 때문에 speak()를 호출할 때마다 새로운 클라이언트를 만들 필요가 없습니다.
반복적으로 음성을 출력하는 시스템에서는 이런 방식이 더 효율적입니다.
13) synthesize 메서드의 역할
def synthesize(self, text: str) -> bytes:synthesize() 메서드는 문자열을 받아 음성 데이터로 변환합니다.
입력값은 문자열이고 반환값은 bytes 형식입니다.
text: str입력 문장이 문자열임을 나타냅니다.
-> bytes음성 데이터가 바이트 배열로 반환된다는 의미입니다.
사용 예시는 다음과 같습니다.
audio_data = tts.synthesize(
    "안녕하세요."
)
이 단계에서는 음성이 재생되지 않습니다. Google Cloud가 생성한 오디오 데이터만 메모리에 반환됩니다.
14) 입력 문자열 정리
clean_text = text.strip()strip()은 문자열 앞뒤의 공백과 줄바꿈 문자를 제거합니다.
예를 들어 다음 문자열이 전달되었다고 가정할 수 있습니다.
text = " 시스템을 시작합니다. "strip() 처리 후에는 다음과 같이 됩니다.
시스템을 시작합니다.사용자가 입력한 문자열에 불필요한 공백이 있더라도 정상적으로 처리할 수 있습니다.
15) 빈 문자열 검사
if not clean_text:
    raise ValueError("음성으로 변환할 문자열이 비어 있습니다.")
공백을 제거한 결과 문자열이 비어 있다면 음성 합성을 진행하지 않습니다.
예를 들어 다음 입력은 모두 오류 처리됩니다.
tts.speak("")tts.speak(" ")tts.speak("\n\t")빈 문자열을 Google API로 보내기 전에 로컬에서 검사하므로 불필요한 API 요청을 방지할 수 있습니다.
ValueError를 사용하는 이유는 메서드에 전달된 값이 올바르지 않기 때문입니다.
호출하는 쪽에서는 다음과 같이 예외를 처리할 수 있습니다.
try:
    tts.speak("   ")
except ValueError as error:
    print(error)
16) SynthesisInput 생성
synthesis_input = texttospeech.SynthesisInput(
    text=clean_text
)SynthesisInput은 Google Cloud에 전달할 입력 문장을 정의합니다.
현재 코드에서는 일반 문자열을 사용합니다.
text=clean_textGoogle Cloud Text-to-Speech는 일반 텍스트 외에도 SSML 방식의 입력을 지원할 수 있습니다.
SSML(Speech Synthesis Markup Language)은 TTS(Text-to-Speech)에 일반 문장 대신 XML 형식의 태그를 넣어 발음, 속도, 높낮이, 쉼, 강조 등을 제어하는 입력 방식입니다.
SSML을 사용하면 다음과 같은 세부 제어가 가능합니다.
- 문장 사이의 정지 시간
- 특정 단어의 강조
- 숫자 읽기 방식
- 날짜 읽기 방식
- 약어 발음 방식
- 말하기 속도 일부 변경
- 음높이 일부 변경
현재 클래스는 단순성과 범용성을 위해 일반 텍스트 입력만 사용합니다.
17) voice_options 딕셔너리 생성
voice_options = {
    "language_code": self.language_code
}
음성 선택 옵션을 딕셔너리 형태로 구성합니다.
최초에는 언어 코드만 포함합니다.
예를 들어 기본 설정에서는 다음과 같은 딕셔너리가 만들어집니다.
{
    "language_code": "ko-KR"
}
18) 음성 이름 조건부 추가
if self.voice_name:
    voice_options["name"] = self.voice_name
voice_name 값이 존재하는 경우에만 음성 이름을 딕셔너리에 추가합니다.
기본 설정에서는 결과가 다음과 같습니다.
{
    "language_code": "ko-KR",
    "name": "ko-KR-Standard-A"
}
반대로 다음처럼 빈 문자열을 전달하면
tts = GoogleTtsEngine(
    voice_name=""
)
name 항목은 추가되지 않습니다.
이 구조를 사용하면 음성 이름을 반드시 지정하지 않아도 됩니다.
19) VoiceSelectionParams 생성
voice = texttospeech.VoiceSelectionParams(
    **voice_options
)VoiceSelectionParams는 사용할 언어와 음성 모델을 정의합니다.
여기서 **voice_options는 딕셔너리에 저장된 값을 키워드 인수로 펼쳐 전달하는 Python 문법입니다.
다음 코드는
voice_options = {
    "language_code": "ko-KR",
    "name": "ko-KR-Standard-A",
}
실질적으로 다음 코드와 같은 의미입니다.
voice = texttospeech.VoiceSelectionParams(
    language_code="ko-KR",
    name="ko-KR-Standard-A",
)
딕셔너리를 사용한 이유는 voice_name을 선택적으로 전달하기 위해서입니다.
20) AudioConfig 생성
audio_config = texttospeech.AudioConfig(
    audio_encoding=texttospeech.AudioEncoding.LINEAR16,
    speaking_rate=self.speaking_rate,
    pitch=self.pitch,
    volume_gain_db=self.volume_gain_db,
)AudioConfig는 생성될 오디오 데이터의 형식과 음성 출력 속성을 정의합니다.
설정 항목은 다음과 같습니다.
- 오디오 인코딩 형식
- 말하기 속도
- 음높이
- 볼륨 증폭값
21) LINEAR16 오디오 형식
audio_encoding=texttospeech.AudioEncoding.LINEAR16LINEAR16은 16비트 PCM 기반의 비압축 오디오 형식입니다.
일반적으로 WAV 재생 환경에서 다루기 쉬운 형식입니다.
이 예제에서 LINEAR16을 선택한 가장 큰 이유는 aplay와 직접 연결하기 편하기 때문입니다.
MP3처럼 압축된 형식을 사용하면 환경에 따라 별도의 디코더가 필요할 수 있습니다.
LINEAR16 방식의 특징은 다음과 같습니다.
- 음질 손실이 적습니다.
- 디코딩 과정이 단순합니다.
- Linux ALSA 환경에서 재생하기 쉽습니다.
- MP3보다 데이터 크기가 큽니다.
- 실시간 시스템에서 처리 구조가 단순합니다.
로봇이나 드론의 상태 안내처럼 짧은 문장을 출력하는 용도라면 데이터 크기가 크게 문제가 되지 않습니다.
22) 음성 합성 API 호출
response = self.client.synthesize_speech(
    input=synthesis_input,
    voice=voice,
    audio_config=audio_config,
)
이 부분에서 실제 Google Cloud Text-to-Speech API 요청이 발생합니다.
전달되는 정보는 다음과 같습니다.
input: 읽을 문자열voice: 사용할 언어와 음성audio_config: 오디오 형식과 속도, 음높이, 볼륨
API 호출이 정상적으로 처리되면 응답 객체가 반환됩니다.
네트워크가 연결되지 않았거나 인증 정보가 잘못된 경우에는 이 단계에서 예외가 발생합니다.
주요 오류 원인은 다음과 같습니다.
- 인터넷 연결 실패
- 서비스 계정 인증 실패
- Text-to-Speech API 비활성화
- 프로젝트 결제 설정 문제
- 사용량 제한 초과
- 잘못된 음성 이름
- 지원되지 않는 언어 코드
- 잘못된 속도 또는 음높이 값
23) 오디오 데이터 반환
return response.audio_contentGoogle Cloud 응답에서 실제 오디오 데이터만 추출하여 반환합니다.
response.audio_content의 자료형은 bytes입니다.
이 데이터를 파일로 저장하면 WAV 파일로 사용할 수 있습니다.
audio_data = tts.synthesize(
    "파일로 저장할 음성입니다."
)

with open("output.wav", "wb") as file:
    file.write(audio_data)
현재 클래스는 파일 저장이 목적이 아니라 즉시 재생이 목적이므로, 반환된 데이터를 play() 메서드로 전달합니다.
24) play 메서드의 역할
def play(self, audio_content: bytes) -> None:play() 메서드는 바이트 형식의 오디오 데이터를 받아 Linux 스피커로 출력합니다.
입력값은 다음과 같습니다.
audio_content: bytes반환값은 없습니다.
-> None이 메서드는 Google Cloud API를 호출하지 않습니다. 이미 생성된 오디오 데이터만 재생합니다.
따라서 같은 음성 데이터를 여러 번 재생할 수도 있습니다.
audio_data = tts.synthesize(
    "경고합니다."
)

tts.play(audio_data)
tts.play(audio_data)
tts.play(audio_data)
25) 기본 aplay 명령어 생성
command = ["aplay", "-q"]외부 명령어는 문자열 하나가 아니라 리스트 형태로 정의합니다.
실제로 실행되는 명령어는 다음과 같습니다.
aplay -q-q 옵션은 quiet 모드를 의미합니다.
이 옵션을 사용하면 aplay가 재생 중에 출력하는 불필요한 메시지를 줄일 수 있습니다.
리스트 형태로 명령어를 전달하는 방식은 쉘 문자열을 직접 실행하는 것보다 안전합니다.
예를 들어 다음처럼 구성하지 않습니다.
command = f"aplay -q -D {self.audio_device}"대신 각 인수를 독립적인 리스트 항목으로 전달합니다.
[
    "aplay",
    "-q",
    "-D",
    "plughw:2,0",
]
26) 출력 장치 조건부 설정
if self.audio_device and self.audio_device != "default":오디오 장치 이름이 존재하고 값이 default가 아닌 경우에만 -D 옵션을 추가합니다.
기본 장치를 사용할 때는 다음 명령어가 실행됩니다.
aplay -q특정 장치를 설정한 경우에는 다음과 같은 명령어가 실행됩니다.
aplay -q -D plughw:2,0장치 옵션은 다음 코드로 추가됩니다.
command.extend([
    "-D",
    self.audio_device,
])extend()는 리스트에 여러 항목을 추가합니다.
초기 리스트가 다음과 같다면
["aplay", "-q"]실행 후에는 다음과 같이 됩니다.
[
    "aplay",
    "-q",
    "-D",
    "plughw:2,0",
]
27) subprocess.run 실행
result = subprocess.run(
    command,
    input=audio_content,
    stdout=subprocess.DEVNULL,
    stderr=subprocess.PIPE,
    check=False,
)
이 코드가 실제로 aplay 프로그램을 실행합니다.
각 옵션의 역할을 하나씩 살펴보겠습니다.
a. command 인수
command실행할 프로그램과 옵션이 담긴 리스트입니다.
예를 들어 다음 형태입니다.
["aplay", "-q"]또는 다음 형태가 될 수 있습니다.
["aplay", "-q", "-D", "plughw:2,0"]b. input 인수
input=audio_contentaudio_content를 aplay 프로세스의 표준 입력으로 전달합니다.
일반적으로 파일을 재생할 때는 다음처럼 실행합니다.
aplay output.wav현재 코드는 파일 경로를 전달하지 않습니다.
대신 Python 메모리에 저장된 WAV 데이터를 aplay에 직접 전달합니다.
개념적으로는 다음 명령어와 비슷한 동작입니다.
cat output.wav | aplay하지만 실제 구현에서는 중간 파일 없이 Python이 직접 데이터를 전달합니다.
c. stdout 설정
stdout=subprocess.DEVNULLaplay가 표준 출력으로 보내는 내용을 버립니다.
DEVNULL은 Linux의 /dev/null과 같은 역할을 합니다.
음성 출력만 필요하고 터미널 메시지는 필요하지 않기 때문에 표준 출력을 숨깁니다.
d. stderr 설정
stderr=subprocess.PIPE오류 메시지는 버리지 않고 Python 프로그램으로 가져옵니다.
aplay 실행에 실패하면 오류 내용이 result.stderr에 저장됩니다.
이 값을 이용해 다음과 같은 오류를 확인할 수 있습니다.
- 오디오 장치를 찾을 수 없음
- 장치가 다른 프로그램에서 사용 중임
- ALSA 설정 오류
- 지원되지 않는 오디오 형식
- 권한 부족
aplay실행 파일 없음
e. check 설정
check=Falsecheck=False는 외부 프로그램이 실패해도 subprocess.run() 자체에서 즉시 예외를 발생시키지 않도록 합니다.
대신 실행 결과의 반환 코드를 직접 검사합니다.
if result.returncode != 0:이 방식은 오류 메시지를 직접 가공하여 더 자세한 예외를 발생시킬 수 있다는 장점이 있습니다.
28) 반환 코드 검사
if result.returncode != 0:Linux 프로그램은 일반적으로 정상 종료 시 0을 반환합니다.
실패하면 0이 아닌 값을 반환합니다.
따라서 다음 조건은 aplay 실행 실패를 의미합니다.
result.returncode != 0예를 들어 오디오 장치가 존재하지 않으면 aplay는 오류 메시지와 함께 비정상 종료 코드를 반환할 수 있습니다.
29) 오류 메시지 디코딩
error_message = result.stderr.decode(
    "utf-8",
    errors="replace",
).strip()result.stderr는 문자열이 아니라 bytes 형식입니다.
사람이 읽을 수 있는 문자열로 바꾸기 위해 decode()를 사용합니다.
.decode("utf-8")오류 출력에 UTF-8로 해석할 수 없는 데이터가 포함된 경우를 대비해 다음 옵션을 사용합니다.
errors="replace"해석할 수 없는 문자는 대체 문자로 변환되므로 디코딩 과정에서 추가 예외가 발생하는 것을 막을 수 있습니다.
마지막의 strip()은 오류 메시지 앞뒤의 공백과 줄바꿈을 제거합니다.
30) RuntimeError 발생
raise RuntimeError(
    "aplay 실행 실패"
    f"(return code={result.returncode}): "
    f"{error_message}"
)
aplay 실행이 실패하면 RuntimeError 예외를 발생시킵니다.
출력되는 오류에는 다음 정보가 포함됩니다.
aplay실행 실패 여부- 프로세스 반환 코드
- ALSA 또는
aplay가 출력한 상세 오류 메시지
예상되는 메시지 형태는 다음과 같습니다.
aplay 실행 실패(return code=1): audio open error: No such file or directory단순히 실패했다고만 출력하는 것보다 실제 오류 원인을 확인하기 쉽습니다.
31) speak 메서드의 역할
def speak(self, text: str) -> None:
    audio_content = self.synthesize(text)
    self.play(audio_content)
speak() 메서드는 음성 합성과 재생을 한 번에 처리하는 편의 메서드입니다.
내부 동작 순서는 다음과 같습니다.
synthesize()로 문자열을 음성 데이터로 변환합니다.- 반환된 음성 데이터를
play()로 전달합니다. aplay를 통해 스피커에서 음성을 출력합니다.
따라서 사용자는 다음 한 줄만 호출하면 됩니다.
tts.speak("시스템을 시작합니다.")이는 내부적으로 다음 코드와 같습니다.
audio_content = tts.synthesize(
    "시스템을 시작합니다."
)

tts.play(audio_content)
a. 말하기 속도와 음높이 변경 예제
tts = GoogleTtsEngine(
    speaking_rate=0.9,
    pitch=-1.5,
)

tts.speak(
    "현재 배터리 잔량은 30퍼센트입니다."
)
이 설정은 기본보다 약간 느리고 낮은 음성으로 출력합니다.
긴급 경고에서는 조금 빠른 속도와 높은 볼륨을 사용할 수 있습니다.
warning_tts = GoogleTtsEngine(
    speaking_rate=1.1,
    pitch=0.0,
    volume_gain_db=4.0,
)

warning_tts.speak(
    "경고합니다. 장애물이 감지되었습니다."
)
b. 특정 ALSA 장치 사용 예제
먼저 출력 장치를 확인합니다.
aplay -l출력 예시는 다음과 같습니다.
card 2: Device [USB Audio Device], device 0: USB Audio이 경우 다음과 같이 설정할 수 있습니다.
tts = GoogleTtsEngine(
    audio_device="plughw:2,0"
)

tts.speak(
    "USB 스피커 출력 테스트입니다."
)
장치 번호는 시스템 재부팅이나 USB 연결 순서에 따라 달라질 수 있습니다.
제품이나 현장 시스템에서는 카드 번호보다 고정된 ALSA 장치 이름을 설정하는 편이 안전합니다.
32) 예외 처리 사용 예제
실제 시스템에서는 네트워크, 인증, 오디오 장치 문제로 음성 출력이 실패할 수 있습니다.
따라서 다음과 같이 예외를 처리하는 것이 좋습니다.
def main() -> None:
    try:
        tts = GoogleTtsEngine()
        tts.speak("시스템을 시작합니다.")

    except ValueError as error:
        print(f"입력 오류: {error}")

    except RuntimeError as error:
        print(f"오디오 재생 오류: {error}")

    except Exception as error:
        print(f"음성 합성 오류: {error}")


if __name__ == "__main__":
main()ValueError는 빈 문자열 입력처럼 잘못된 인수에서 발생합니다.
RuntimeError는 aplay 실행 실패 시 발생합니다.
Google Cloud API 또는 인증 관련 오류는 다른 예외 형태로 발생할 수 있으므로 마지막에 일반 예외 처리도 추가할 수 있습니다.